
摘要
生成式蛋白设计正在将“给定序列预测结构”推进为“给定约束提出序列和结构”。但设计成功必须穿过多个不同环节:骨架满足约束、序列与骨架兼容、样品可获得、构象正确且功能可测。本文围绕 RFdiffusion 与 ProteinMPNN,建立以条件概率和完整淘汰记录为核心的评价框架。我们推导设计漏斗、候选相关性与零失败试验的统计上界,说明自洽预测、序列恢复与真实功能之间不存在自动等价。文章的计算图是预算分析,不是本站完成的新蛋白设计或实验结果。[1] De novo design of protein structure and function with R[2] Robust deep learning–based protein sequence design usin
English abstract
Protein design is an inverse problem whose success requires a chain from geometric generation to sequence compatibility, expression and measured function. We synthesize RFdiffusion and ProteinMPNN while separating self-consistency from independent validation. A conditional funnel and a correlated-library calculation show why a large number of generated candidates is not the same as many independent experimental opportunities. We propose a budget-matched prospective evaluation with complete attrition accounting and orthogonal functional endpoints.
1. 逆问题没有唯一正确答案
蛋白功能约束常允许许多序列与构象,逆向设计的任务不是还原自然序列,而是在可行集合中寻找可实现目标的候选。RFdiffusion 将骨架去噪用于多种设计条件;ProteinMPNN 则在给定骨架条件下生成序列,两者解决相邻而不同的问题。因此,不能把一个阶段的概率或分数解释成整个设计链成功率。本文建议先把目标写成可测终点与允许误差,再区分必须保持的基序、可变化区域和后续筛选标准,防止任务在生成后被事后改写成候选恰好擅长的形式。[1] De novo design of protein structure and function with R[2] Robust deep learning–based protein sequence design usin
2. 生成模型学习的是分布与条件,不是物理定理
RFdiffusion 将结构预测网络适配到去噪任务,展示了包括结合体与对称组装在内的设计能力。条件化机制让研究者将局部几何约束嵌入生成过程,但模型仍由训练结构和任务设置限定。约束满足不保证能量地形、折叠动力学或溶液行为。这里的关键方法学问题是约束强度:约束太弱,候选可能偏离功能几何;约束太强,则可能只留下很窄、彼此相似的设计族。评估应同时展示约束误差与设计族数量,而非只展示最精美的单个构象。[1] De novo design of protein structure and function with R
3. 序列恢复率解释的是模型一致性的一部分
ProteinMPNN 在原文原生骨架测试中报告了较高的序列恢复,并通过多种结构和组装实验检验设计。原生序列恢复率可以衡量条件建模的一部分能力,却不能成为新功能成功的充分条件:许多不同序列都可形成类似骨架,而一个关键位点改变也可能影响折叠或活性。设计评估应同时保存骨架、条件序列分布与保留位点;若用结构预测器作过滤,还应记录预测器与生成器的训练亲缘,避免把同一种偏差的一致性当成独立支持。[2] Robust deep learning–based protein sequence design usin[1] De novo design of protein structure and function with R
4. 本文推导:成功漏斗的分母必须从生成开始
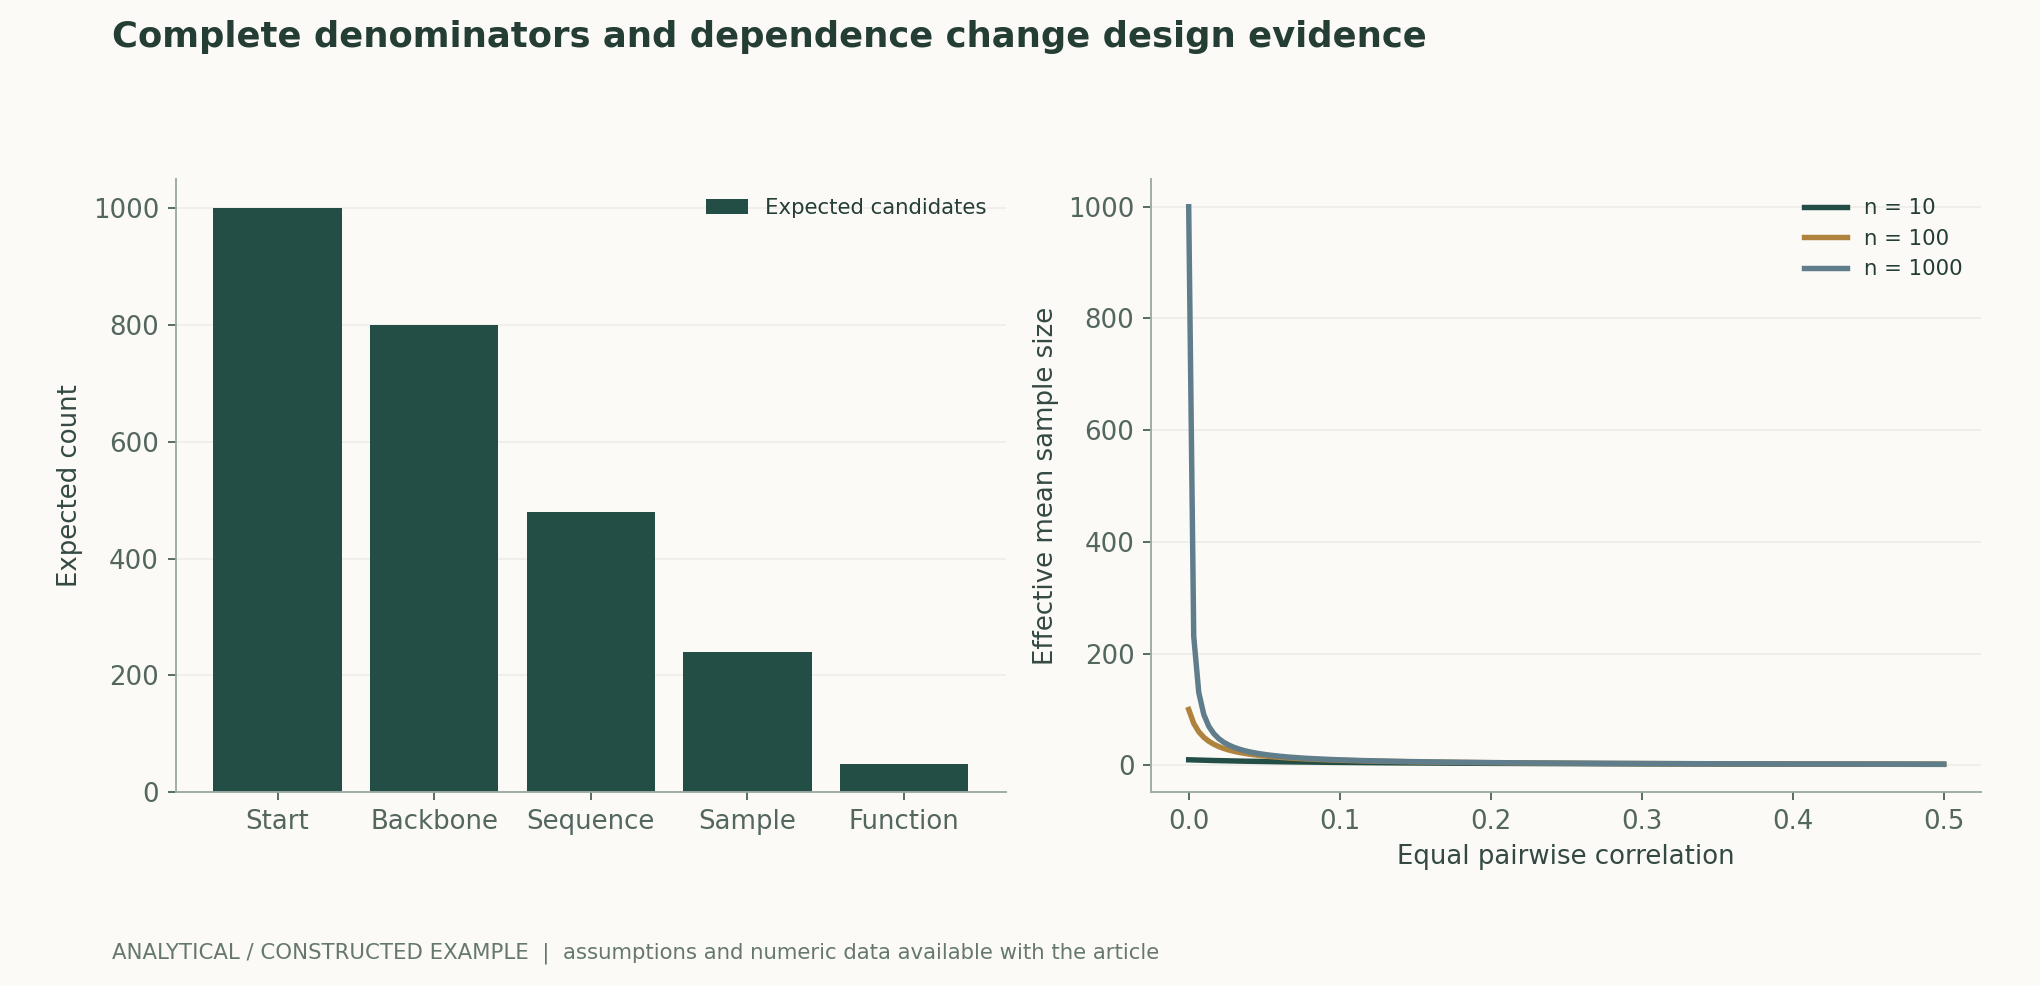
设骨架通过、序列通过、可获得样品与功能通过构成四个连续环节,每一步概率都条件于前序通过。全链成功率是这些条件概率的乘积,并不需要额外假设各阶段边际独立。构造例中依次取 0.8、0.6、0.5、0.2,1000 个起始候选对应期望 48 个功能通过;如果只在最后 240 个样品中计数,则会报告 20%,与起始候选口径的 4.8% 回答不同问题。图把两种分母并列,帮助读者识别筛选效率与端到端产率的差别。作者分析与复核建议 / Author analysis
5. 本文分析:序列多样性不能用文件数量代替
若一批候选共享相同骨架、接触模式与主要序列特征,它们的成败可能高度相关。本文使用等相关均值估计的有效样本量作为预算警示:100 个候选在相关系数 0.2 的构造条件下,仅相当于约 4.81 个独立样本对均值精度的贡献。这个公式不精确描述二元设计成败,也不把家族相似度直接等同于相关系数;它提示应按骨架、序列和界面共同聚类,并报告跨族成功率。多样性应进入候选选择目标,而不只是成为结果展示中的附加形容词。作者分析与复核建议 / Author analysis
6. 自洽结构过滤应该怎样使用
生成后再由结构预测器检查序列能否回到目标骨架,是有价值的低成本过滤步骤;RFdiffusion 与 ProteinMPNN 相关研究将计算筛选和实验表征结合起来。其局限在于预测器可能与生成器共享结构偏好,也可能忽视某些无序、聚集或错误寡聚状态。因此,本文主张将自洽性标记为一个计算证据字段,外部结构与功能证据另行登记。对同一筛选器优化数千轮后,应在冻结筛选规则的候选之外检验迁移能力,不能把训练适应后的高分当成全新发现。[1] De novo design of protein structure and function with R[2] Robust deep learning–based protein sequence design usin[3] Accurate structure prediction of biomolecular interacti
7. 本文推导:没有看到失败仍然需要区间
在独立且同分布的试验假设下,如果 n 次试验都未观察到某类失败,单侧 95% 上界为 1−0.05 的 1/n 次方。n=30 时上界仍约 9.50%,n=300 时约 0.994%。因此“全部通过”必须伴随样本量、独立性和终点定义。设计库中的家族相关会进一步削弱独立假设。我们建议按实验批次与设计族报告结果,保留表达失败、样品不纯和不可测对象,避免在删除这些对象后宣布零失败。该推导只处理统计口径,不估计任何已发表模型的失败率。作者分析与复核建议 / Author analysis
8. 结构命中与功能命中需要不同对照
设计蛋白可能形成预期形状却缺乏目标功能,也可能存在多种构象而仍表现出某项功能。要理解设计成功的原因,应设置能分别挑战几何与机制的对照,例如比较保留骨架但改变关键局部条件的候选,并独立记录样品状态。具体研究还应检查目标之外的选择性与批次重现性。本文将这些作为研究设计要求,而不是未做实验的结果。只有对照能区分“模型恰好生成了稳定蛋白”和“模型满足了指定功能”,设计故事才能成为可靠的科学解释。作者分析与复核建议 / Author analysis
9. 一个更严格的预算匹配评估
我们提出将不同管线分配相同生成预算与相同后续验证预算,预先固定目标集合、允许调整次数和停止规则。主要终点为每单位实验预算获得的独立功能族数量,辅以从全部起始候选计算的成功率。比较应包含简单基线、只改骨架、只改序列和完整闭环等消融,失败原因按层级登记。若某方法提高了最后阶段命中率却显著增加前端筛选成本,结论应同时呈现成本和产出,而不能只凭精选样品中的高比例宣称普遍优势。作者分析与复核建议 / Author analysis
技术补充 A · 结构去噪中的坐标对称性
蛋白骨架坐标的整体旋转和平移不改变其物理身份,因此生成过程必须合理处理这些对称性。将坐标噪声、局部框架与条件基序连接,可以让模型在几何约束下探索多种骨架;但固定某些位置也改变了可行集合。本文建议用同一输入作刚体变换,核对输出分布在逆变换后是否保持相应关系,并把基序误差、键几何与全局折叠分开。这个测试属于实现和表示验证,不能代替蛋白是否表达、溶解或有功能的外部测量。[1] De novo design of protein structure and function with R
技术补充 B · 条件序列概率的解码顺序
给定骨架后,序列分布可以按不同位置顺序分解成条件概率的乘积。若使用自回归解码,前面已选位置会影响后面候选;温度与多次采样改变的是探索方式,不自动改变最终实验分布。对称组装中等价位置可能被绑定,这减少自由度,也会改变有效多样性。本文建议同时记录解码顺序、固定残基、对称绑定、温度和种子,按最终序列与结构家族去重。只公布一个平均序列概率不能解释候选之间的相关性或功能差异。[2] Robust deep learning–based protein sequence design usin
技术补充 C · 信息价值比继续采样更重要
若一个设计族已经反复出现样品不可获得,继续从同族采样可能只增加相似失败。本文提出以尚未区分的失败机制作为下一步测量目标:例如先判断是骨架稳定性、样品状态还是功能几何限制,再决定改变哪个阶段。这个思路可写成条件信息增益,而不是简单选择最高模型分数。评估时应记录测量怎样改变了后续候选分布,并以预注册目标比较纯采样和反馈策略。没有实际反馈实验时,只能提出设计,不得声称主动学习已提升真实命中。作者分析与复核建议 / Author analysis
技术补充 D · 从家族内成功到目标迁移
一个靶标上得到多个相近成功候选,证明该局部设计空间存在可行解;新靶标迁移则要求不同表面、几何和测量条件下仍有效。本文建议以目标为外层、设计族为中层、候选为内层组织数据,分别报告三层变异。若目标数量很少,不能用候选总数给出极窄的跨目标区间。预算匹配也应在目标层进行,避免某方法只在容易靶标上投入更多。这样,设计平台能力才能与单个成功案例的精细优化清楚地区分。作者分析与复核建议 / Author analysis
10. 可复核的设计成果应交付什么
最有价值的公开包不是只给最佳结构,而是把目标规格、生成条件、候选家族、筛选账本、样品身份和功能终点连接起来。本文的公式与图表将设计效率写成可检查的分母关系,原论文的实验结果仍归原团队。后续复现应保存与原设置的差异,并允许负结果附着到准确候选与版本。这样,设计平台才能从不断重复的成功示例,转向可累计知识的工程与科学系统:读者知道什么已经被测量,也知道下一个最有信息量的实验应回答什么问题。作者分析与复核建议 / Author analysis
核心公式与推导
(1) 骨架 x、序列 s 与约束 c 的管线分解;这是建模组织形式,不保证物理或功能成立。
LaTeX
p(x,s\mid c)=p_\theta(x\mid c)\,p_\phi(s\mid x,c)(2) 四阶段条件链,分别对应骨架、序列、样品与功能通过;不要求边际独立。
LaTeX
P(F)=P(B)P(S\mid B)P(E\mid S,B)P(F\mid E,S,B)(3) 等方差等相关样本均值的有效样本量,用作相关设计库的解析警示,非真实成败拟合。
LaTeX
n_{\mathrm{eff}}=\frac{n}{1+(n-1)\rho}(4) n 次独立同分布试验零失败的单侧 95% 精确上界;相关样本不能直接套用。
LaTeX
p_{\mathrm{failure,upper}}=1-0.05^{1/n}方法与证据流程
解析图与数值示例
可复算例题
1000×0.8×0.6×0.5×0.2=48,起始口径4.8%,最后样品口径20%;100个等相关样本在rho=0.2时有效样本量约4.80769。
方法比较
| 交付环节 | 可测证据 | 应保留的失败与分母 |
|---|---|---|
| 约束骨架 | 几何误差与可行性 | 所有生成与无效骨架 |
| 条件序列 | 固定位置、序列分布 | 所有骨架对应候选 |
| 自洽预测 | 结构回归与界面评分 | 预测器版本和筛选淘汰 |
| 样品获得 | 表达、纯度与身份 | 不可获得和不可测对象 |
| 功能命中 | 预定义终点与对照 | 全部送验样品及独立家族 |
| 泛化与成本 | 新靶标、跨批次、预算 | 调参次数、人工介入和耗时 |
复核与实验方案
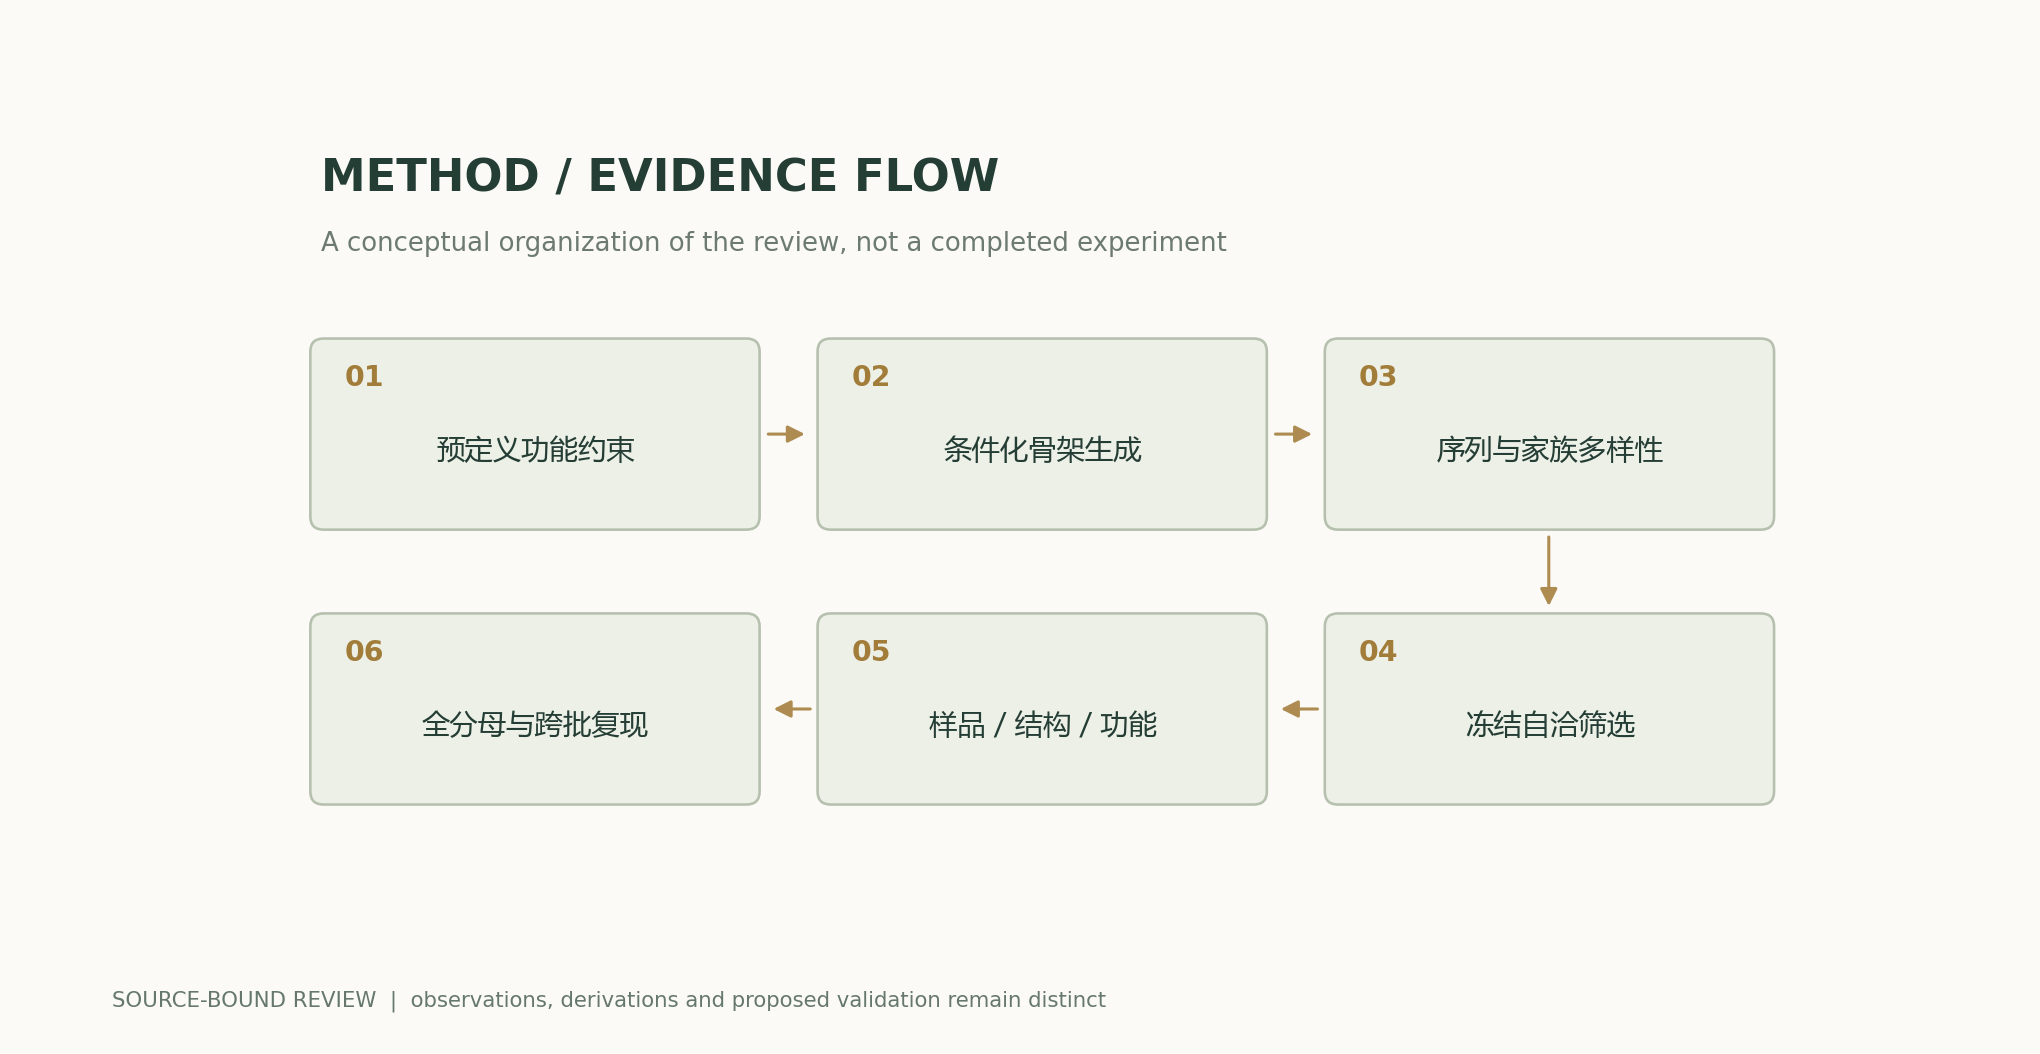
- 预注册目标、允许几何变化、主要功能终点与候选筛选上限。
- 固定模型与条件生成配置,交付骨架、序列、种子与摘要。
- 将候选按序列、骨架和接触几何聚类,记录每族全部成员。
- 为不同方法匹配生成预算和独立验证预算,保存简单基线。
- 冻结自洽筛选器与阈值,记录每一步淘汰原因。
- 样品不可获得与不可测都计入对应分母,不静默删除。
- 将结构和功能终点分别确认,按批次与家族给出区间。
- 公开失败与复现差异;未完成的验证仅登记为计划,不计为功能设计成果。
适用范围与局限
- 没有运行模型或制备新蛋白。
- 漏斗中的概率为构造输入,不代表 RFdiffusion 的命中率。
- 有效样本量公式适用于等相关均值分析,不是序列相似性定律。
- 零失败上界要求独立同分布与固定终点。
- 结构、表达与功能仍受具体体系和测量条件限制。
原研究证据与适用范围
| 原研究结果 | 适用范围 | 来源与位置 |
|---|---|---|
| 展示多类条件蛋白设计并对设计结构与功能进行实验表征。 | 实验只支持原研究测试的目标、样本与条件。 | De novo design of protein structure and function with RFdiffusionAbstract; design tasks and characterization |
| 原生骨架序列恢复与多种实验设计检验。 | 序列恢复不是新功能的充分条件。 | Robust deep learning–based protein sequence design using ProteinMPNNResults and Conclusion |
值得检验的研究问题
- 固定预算下,跨家族多样性是否提高独立功能族产出?
- 计算自洽性在新目标上的校准能否跨生成器迁移?
- 哪些失败阶段最值得追加测量,而非继续增加采样?
一手来源与主张对应
- De novo design of protein structure and function with RFdiffusionWatson et al. · 2023-07-11Abstract; conditional backbone generation, experimental characterization and limitations.
- Robust deep learning–based protein sequence design using ProteinMPNNDauparas et al. · 2022-09-15Abstract and Results; native sequence recovery is distinct from folding and functional validation.
- Accurate structure prediction of biomolecular interactions with AlphaFold 3Abramson et al. · 2024-05-08Nature 2024; diffusion module and limitations
引用与文稿导出
BibTeXRISCSL JSONTXTArticle JSON
作者、版本与来源
Codex(AI)撰写的有来源研究综述与原创解析。原论文实验归原研究团队;本文计算仅检验所列公式和明示假设。 本站尚无本篇独立同行评审或原创模型、临床及物理实验记录。
首次发布:AI与科学发现深度专题;保留逐节来源、原研究证据与作者解析的边界。
概念封面由 ImageGen 生成。科学图由随文代码与数值文件绘制,图注逐项说明假设与测量口径。
封面与科学图来源 · 数据、来源与假设 · Python · 可复算代码 · 发布与版本记录
Source revision: b7b48f7205d705b2a3d3e8de0be5e1b458e4869c