
Resumen
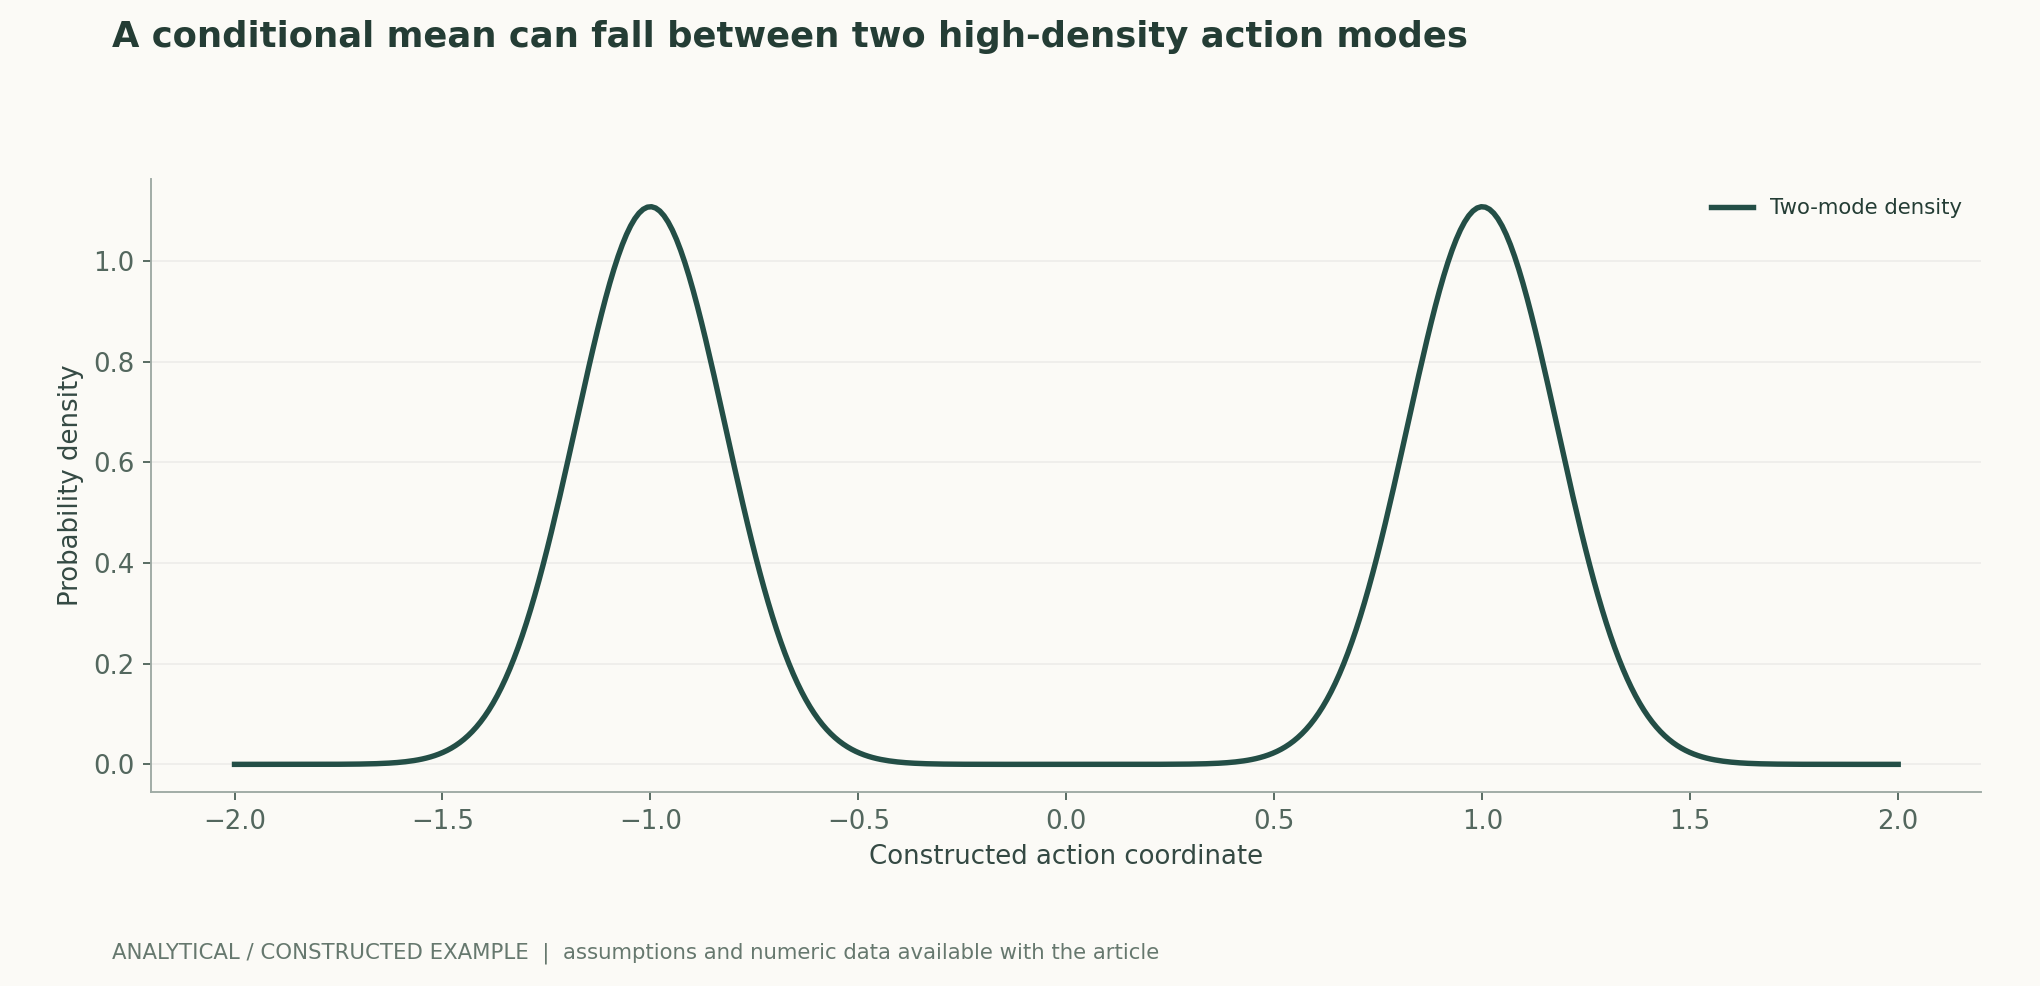
Las demostraciones robóticas pueden contener varias estrategias razonables, y promediar directamente las acciones puede producir una acción en una región de probabilidad muy baja en las demostraciones. Las políticas de difusión modelan secuencias de acciones mediante eliminación de ruido condicionada, pero el éxito en lazo cerrado también depende de la percepción, la latencia, la ventana de ejecución y los cambios en la distribución de estados. Este artículo compara las interfaces de las políticas generativas, los datos de múltiples tareas y los métodos de visión, lenguaje y acción, y propone pruebas de aceptación por etapas, desde la evaluación fuera de línea hasta las pruebas físicas controladas. La figura muestra una distribución bimodal construida y no corresponde a trayectorias robóticas reales.[1] Diffusion Policy: Visuomotor Policy Learning via Action[2] Learning Fine-Grained Bimanual Manipulation with Low-Co[3] RT-2: Vision-Language-Action Models Transfer Web Knowle
Traducción del resumen original en inglés
Las políticas de difusión modelan secuencias de acciones condicionadas en lugar de una única acción media. Utilizamos una densidad bimodal especificada explícitamente para explicar por qué promediar puede producir una acción de baja densidad y, a continuación, analizamos la ejecución con horizonte deslizante y la latencia. La figura no representa datos de trayectorias robóticas. La calidad de predicción fuera de línea, el éxito en lazo cerrado y la seguridad requieren validaciones independientes.
1. Las acciones multimodales no pueden sustituirse arbitrariamente por su media
Una misma observación puede permitir rodear un objeto por la izquierda o por la derecha. Ambas acciones son razonables, pero su media puede apuntar hacia un obstáculo situado en el centro. Este ejemplo muestra que la media condicional obtenida mediante regresión con error cuadrático difiere de una política ejecutable, aunque no todas las tareas requieren un modelo multimodal. Las políticas de difusión generan secuencias de acciones mediante eliminación de ruido condicionada y pueden representar varios modos candidatos; para determinar si realmente abarcan las demostraciones y generan acciones estables, aún deben comprobarse las unidades de las acciones, sus límites, los sistemas de coordenadas y la distribución de entrenamiento.[1] Diffusion Policy: Visuomotor Policy Learning via Action
2. La generación de secuencias y la replanificación en lazo cerrado trabajan conjuntamente
Una política puede predecir una ventana de acciones, ejecutar solo una parte y volver a percibir y planificar. Una ventana más larga reduce la frecuencia de recálculo, pero puede prolongar la dependencia de observaciones desactualizadas durante la ejecución; una ventana más corta responde con mayor rapidez, pero aumenta las exigencias de inferencia y comunicación. Tanto el número de pasos de eliminación de ruido como la longitud de la salida afectan a la latencia. Las comparaciones deben mantener fijas la frecuencia de percepción, la ventana de ejecución y la interfaz del controlador; no puede inferirse el éxito en tareas reales únicamente a partir del error de acciones fuera de línea.[1] Diffusion Policy: Visuomotor Policy Learning via Action
3. El preentrenamiento y los datos de múltiples tareas modifican el ámbito de aplicación
RT-1 estudia el escalado de datos de tareas robóticas reales y el modelado de secuencias, mientras que RT-2 vincula el conocimiento visual y lingüístico con las representaciones de acciones. Estos trabajos ofrecen distintas vías de representación y entrenamiento, pero difieren en sus datos, robots, discretización de acciones y definiciones de tareas, por lo que no pueden clasificarse directamente según las cifras de sus resúmenes. Antes de transferirlos a una nueva plataforma, deben precisarse la semántica de las acciones, la calibración de las cámaras, el espacio de trabajo y la cobertura del entrenamiento; la comprensión del lenguaje no puede sustituir la dinámica física ni la fiabilidad de la ejecución.[2] Learning Fine-Grained Bimanual Manipulation with Low-Co[3] RT-2: Vision-Language-Action Models Transfer Web Knowle
4. El presupuesto de latencia forma parte de la política
La latencia total de la adquisición sensorial, el preprocesamiento, la inferencia del modelo, la comunicación y la preparación de la ejecución debe ser compatible con el período de control. Aunque la latencia media cumpla los requisitos, la latencia de cola puede provocar inestabilidad o riesgos para la seguridad. Deben medirse la alineación de las marcas temporales, las observaciones obsoletas, la pérdida de fotogramas y el comportamiento tras agotar el tiempo de espera, y la ejecución debe restringirse mediante mecanismos independientes de limitación y parada. No se conectó ningún robot para este artículo; toda prueba real debe realizarse primero en un entorno controlado y legalmente permitido, y las acciones generadas no deben tratarse directamente como instrucciones seguras.[1] Diffusion Policy: Visuomotor Policy Learning via Action[2] Learning Fine-Grained Bimanual Manipulation with Low-Co
5. Las puntuaciones fuera de línea y el éxito en lazo cerrado requieren datos diferentes
La validación fuera de línea solo examina las predicciones de acciones próximas a las demostraciones, mientras que los errores en lazo cerrado modifican los estados posteriores y hacen que el modelo encuentre observaciones menos frecuentes durante el entrenamiento. Las pruebas de aceptación deben comenzar verificando la interfaz de acciones y la simulación, y después evaluar la capacidad de recuperación mediante perturbaciones controladas, registrando por separado indicadores como el éxito de la tarea, las colisiones, las tomas de control y los tiempos de espera agotados. Los ensayos repetidos deben abarcar distintas posiciones de objetos, condiciones de iluminación y estados iniciales; los fallos no deben eliminarse antes del análisis estadístico. Los indicadores de seguridad y los de la tarea deben comunicarse por separado.[1] Diffusion Policy: Visuomotor Policy Learning via Action[3] RT-2: Vision-Language-Action Models Transfer Web Knowle
6. Los registros de reproducción deben incluir el hardware y las condiciones de operación
Deben conservarse registros del robot, el efector final, el firmware, las cámaras, la calibración, la frecuencia de control y las versiones de los datos y del modelo. La variación ambiental en los ensayos reales puede superar las diferencias entre algoritmos, por lo que se requieren un orden aleatorizado, la misma distribución inicial y suficientes repeticiones. Quienes reproduzcan el trabajo deben indicar qué condiciones coinciden y cuáles difieren, y registrar los casos sin éxito. Este artículo solo explica la multimodalidad y las restricciones de control; no ha realizado experimentos robóticos ni afirma haber obtenido una tasa de éxito físico.[1] Diffusion Policy: Visuomotor Policy Learning via Action[2] Learning Fine-Grained Bimanual Manipulation with Low-Co[3] RT-2: Vision-Language-Action Models Transfer Web Knowle
Ecuaciones fundamentales y derivaciones
(1) Distribución condicional de secuencias de acciones; deben especificarse el historial de observaciones, la parametrización de las acciones y la ventana de ejecución.
LaTeX
\pi_\theta(a_{t:t+H}\mid o_{\le t})(2) Esquema de la función objetivo de eliminación de ruido en las acciones; no equivale a la tasa de colisiones, la estabilidad ni la tasa de éxito en tareas reales.
LaTeX
\mathcal L=\mathbb E\|\epsilon-\epsilon_\theta(a^{(s)},s,o)\|_2^2(3) Deben considerarse la latencia de cola y las marcas temporales; cumplir el presupuesto medio no constituye una prueba de seguridad del control.
LaTeX
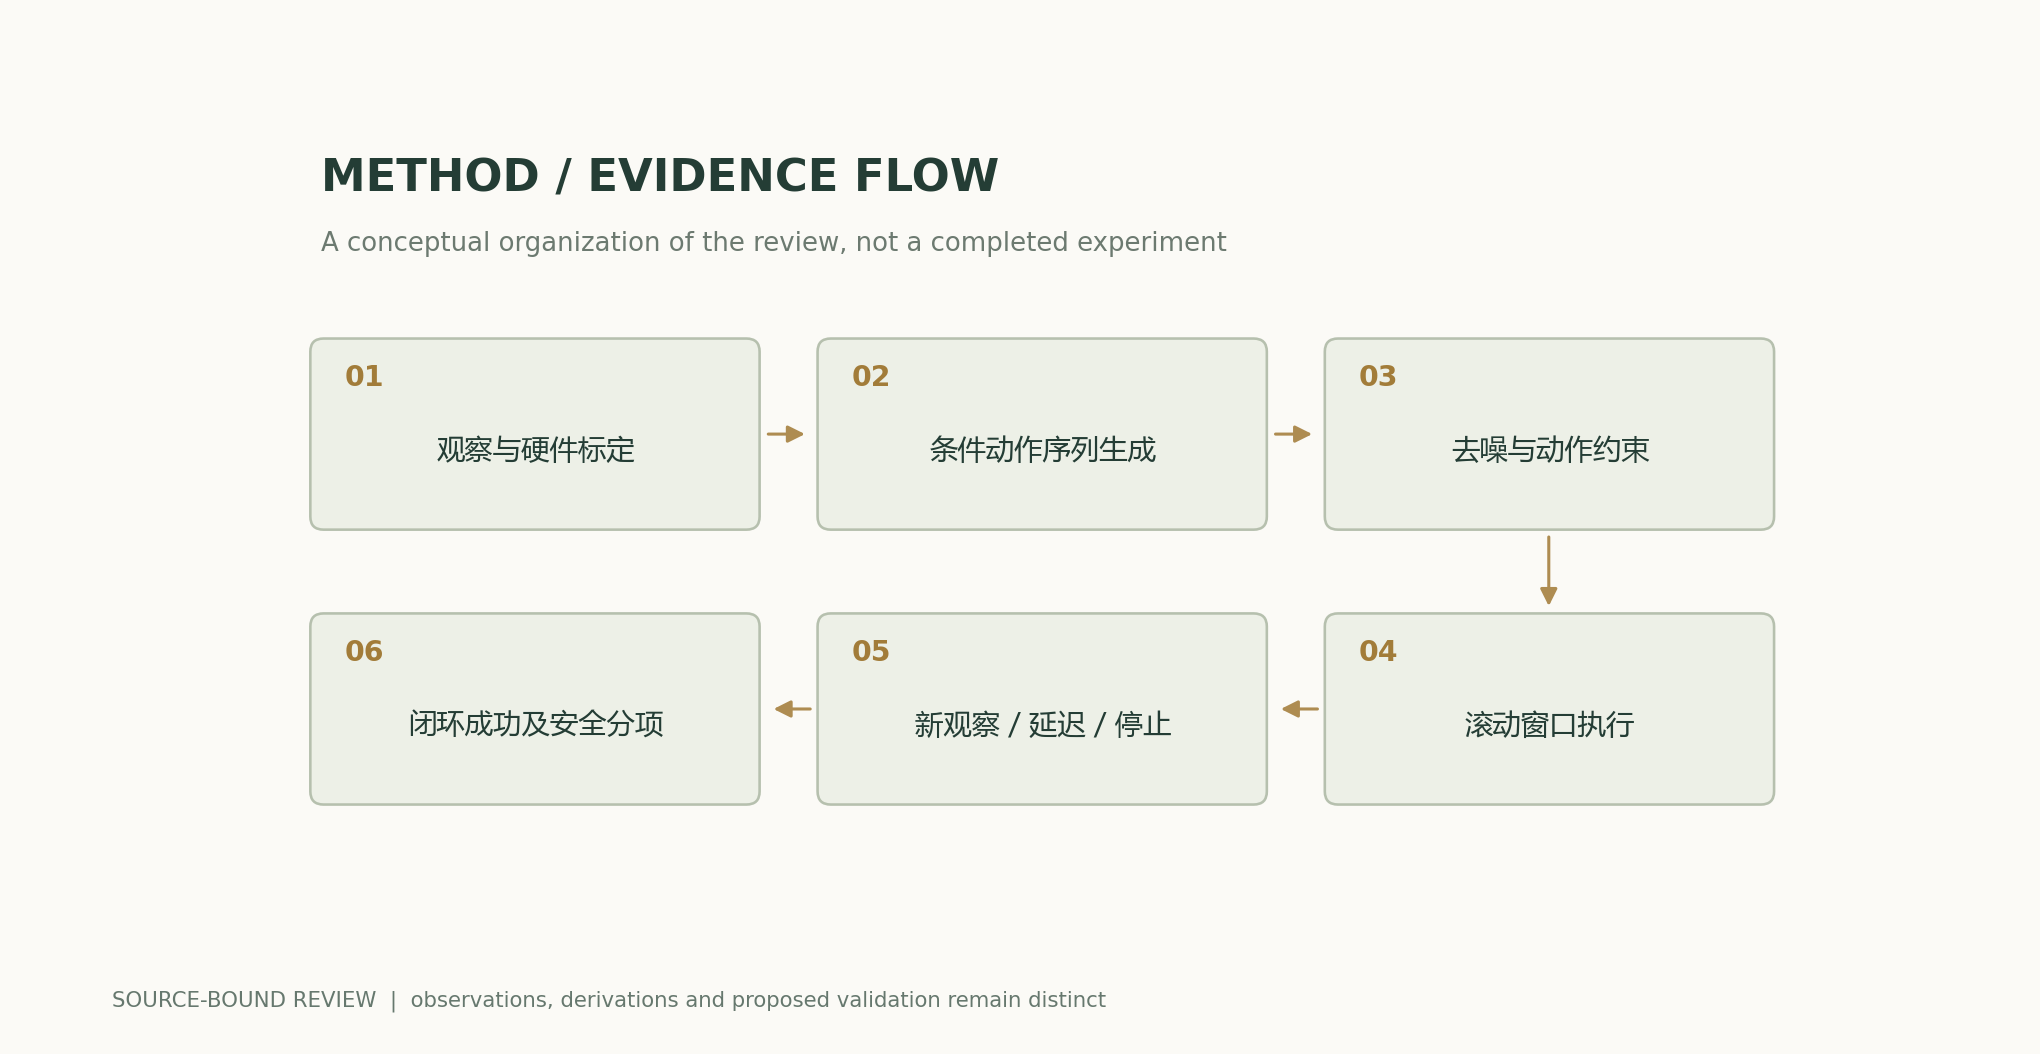
\tau_{\mathrm{sense}}+\tau_{\mathrm{infer}}+\tau_{\mathrm{comm}}+\tau_{\mathrm{prepare}}\le T_{\mathrm{budget}}Flujo metodológico y de evidencia
Figuras analíticas y ejemplos numéricos
Ejemplo resuelto que permite repetir los cálculos
La media de la distribución bimodal simétrica es 0, pero la densidad cerca de 0 es mucho menor que en ±1. Esto ilustra que la media puede no representar un modo factible; no demuestra que las políticas de difusión satisfagan automáticamente restricción robótica alguna.
Comparación de métodos
| Método o valoración | Variables controladas y mediciones | Condiciones de fallo y explicaciones |
|---|---|---|
| Política multimodal | Comprobar los modos de acción, las unidades y las restricciones | La media condicional puede carecer de respaldo en acciones ejecutables |
| Ejecución con horizonte deslizante | Fijar las ventanas de predicción y ejecución | Las ventanas largas implican un compromiso con la actualidad de la realimentación |
| Transferencia entre tareas | Verificar la plataforma, la calibración y la cobertura de los datos | La capacidad lingüística no equivale a fiabilidad física |
| Pruebas de aceptación físicas | Desglosar el éxito, las tomas de control, las colisiones y los tiempos de espera agotados | El error fuera de línea no puede sustituir las pruebas en lazo cerrado |
Plan de verificación y experimentación
- Fijar el hardware, la calibración, los sistemas de coordenadas, las unidades de las acciones y la versión de la interfaz de control.
- Dividir las demostraciones por tarea y entorno para evitar que segmentos de trayectoria adyacentes queden repartidos entre entrenamiento y prueba.
- Comprobar primero los rangos de salida, los límites, la parada y la simulación; después, proceder a los ensayos físicos controlados.
- Fijar las ventanas de replanificación y ejecución, y medir la latencia de cola y las observaciones obsoletas en todas las etapas.
- Aleatorizar los estados iniciales y repetir los ensayos, registrando de forma independiente el éxito, las colisiones, las tomas de control, los tiempos de espera agotados y la recuperación.
- Publicar las diferencias ambientales y los fallos; no sustituir las estadísticas completas de los ensayos por vídeos seleccionados.
Ámbito de aplicación y limitaciones
- La densidad bimodal no representa trayectorias robóticas.
- No se realizaron experimentos con robots físicos.
- La calidad de la distribución de acciones no demuestra la seguridad.
- La transferencia entre plataformas requiere volver a verificar las interfaces.
Correspondencia entre fuentes primarias y afirmaciones
- Diffusion Policy: Visuomotor Policy Learning via Action Diffusion, , , , , , , · 2023-03-07Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware, , , · 2023-04-23Abstract; 原文方法、理论和实验章节见作者原始论文链接
- RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control, , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , -------------------------------------------------------------------------------- · 2023-07-28Abstract; 原文方法、理论和实验章节见作者原始论文链接
Cita y exportación del artículo
BibTeXRISCSL JSONTXTArtículo JSON
Autor, versión y fuentes
Revisión de investigación asistida por IA; Codex (IA) redactó el artículo y realizó derivaciones analíticas basándose en la bibliografía primaria enumerada. Este sitio no dispone de registros de revisión por pares independiente ni de experimentos originales con modelos para este artículo.
Revisión del rendimiento del lector: también se reutilizan las páginas ya leídas cuando una solicitud HEAD reciente devuelve 200 y el ETag coincide. El texto principal, las ecuaciones, las fuentes y los datos de las figuras científicas conservan el contenido de la versión anterior.
La portada conceptual se mantiene separada de las ilustraciones científicas; las figuras científicas se calculan a partir de ecuaciones públicas y supuestos explícitos, y todos los resultados de los artículos originales se atribuyen a sus fuentes.
Autor, versiones e historial de correcciones · /guides/robotics-diffusion-policy/v1/
Fuentes de la portada y de las figuras científicas · Datos, fuentes y supuestos · Historial de publicación y versiones
Revisión de la fuente: 6251a250b27bb8b449f59b392f81abd355383770