
要旨
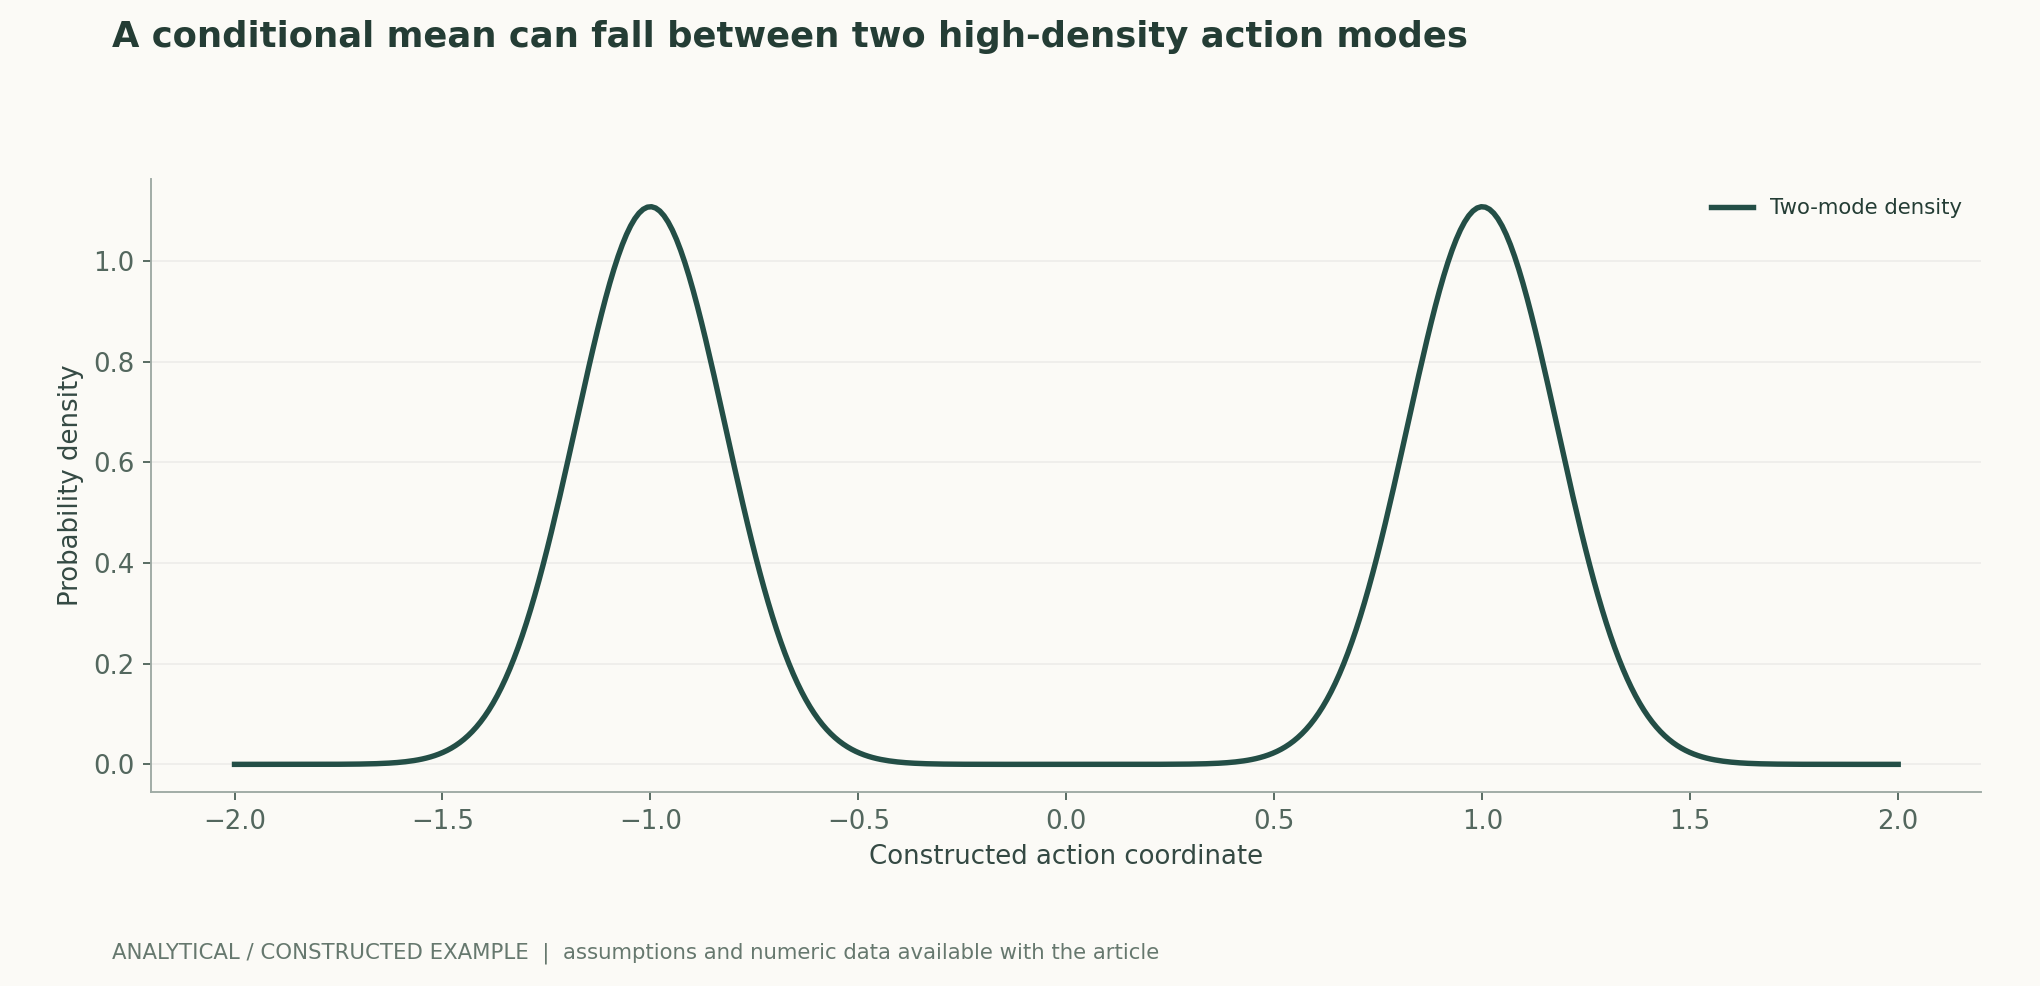
ロボットのデモンストレーションには複数の妥当な戦略が含まれうるため、行動を直接平均すると、デモンストレーションにおける確率が極めて低い領域に入る可能性がある。拡散方策は条件付きノイズ除去によって行動系列をモデル化するが、閉ループでの成功は、知覚、遅延、実行窓、状態分布の変化にも依存する。本稿では、生成方策、タスク横断データ、視覚・言語・行動手法のインターフェースを比較し、オフライン評価から管理された実機試験に至る段階的な受入検証を提案する。図は構成した二峰性分布であり、実際のロボット軌跡には対応しない。[1] Diffusion Policy: Visuomotor Policy Learning via Action[2] Learning Fine-Grained Bimanual Manipulation with Low-Co[3] RT-2: Vision-Language-Action Models Transfer Web Knowle
原文英語要旨の日本語訳
拡散方策は、単一の平均行動ではなく、条件付き行動系列をモデル化する。明示的に定めた二峰性密度を用いて、平均化が低密度の行動を生みうる理由を説明し、その後、リシーディングホライズン方式の実行と遅延を分析する。この図はロボット軌跡データではない。オフライン予測の品質、閉ループでの成功、安全性には、それぞれ独立した検証が必要である。
1. 多峰性をもつ行動を安易に平均で置き換えてはならない
同一の観測に対して、物体の左側または右側を回り込むことが可能な場合がある。どちらの行動も妥当であるが、その平均は中央の障害物に向かう可能性がある。この例は、二乗誤差回帰による条件付き平均と実行可能な方策が異なることを示すが、すべてのタスクに多峰性モデルが必要というわけではない。拡散方策は条件付きノイズ除去によって行動系列を生成し、複数の候補モードを表現できる。ただし、実際にデモンストレーションを網羅しているか、安定した行動を生成するかについては、行動の単位、制限値、座標系、学習分布を確認する必要がある。[1] Diffusion Policy: Visuomotor Policy Learning via Action
2. 系列生成と閉ループ再計画は連携して機能する
方策は一定の窓に含まれる行動を予測し、その一部のみを実行した後、再び知覚と計画を行うことができる。窓を長くすると再計算の頻度は減るが、実行が古い観測に依存する時間が長くなる可能性がある。窓を短くすると応答は速くなるが、推論と通信の負荷が増す。ノイズ除去のステップ数と出力長はいずれも遅延に影響する。比較時には知覚頻度、実行窓、制御器のインターフェースを固定すべきであり、オフラインの行動誤差のみから実タスクの成功を推定してはならない。[1] Diffusion Policy: Visuomotor Policy Learning via Action
3. 事前学習とタスク横断データは適用範囲を変える
RT-1は実ロボットのタスクデータの大規模化と系列モデリングを研究し、RT-2は視覚・言語の知識と行動表現を結び付けている。これらの研究は異なる表現と学習の方法を提供するが、データ、ロボット、行動の離散化、タスク定義が異なるため、要旨中の数値で直接順位付けすることはできない。新しいプラットフォームへ移行する前に、行動の意味、カメラの較正、作業空間、学習の網羅範囲を明確にすべきである。言語理解能力は、物理的な動力学や実行の信頼性の代わりにはならない。[2] Learning Fine-Grained Bimanual Manipulation with Low-Co[3] RT-2: Vision-Language-Action Models Transfer Web Knowle
4. 遅延予算は方策の一部である
センシング、前処理、モデル推論、通信、実行準備の総遅延は、制御周期と整合していなければならない。平均遅延が要件を満たしていても、テール遅延によって不安定性や安全上のリスクが生じる可能性がある。タイムスタンプの整合、古くなった観測、フレーム欠落、タイムアウト後の挙動を測定し、独立した制限機構と停止機構によって実行を制約すべきである。本稿ではロボットを接続していない。実際の試験は、まず法令に適合した管理環境で行うべきであり、生成された行動をそのまま安全な指令とみなしてはならない。[1] Diffusion Policy: Visuomotor Policy Learning via Action[2] Learning Fine-Grained Bimanual Manipulation with Low-Co
5. オフラインの評価値と閉ループでの成功には異なるデータが必要である
オフライン検証が調べるのはデモンストレーション近傍の行動予測のみである一方、閉ループでの誤差は後続の状態を変化させ、モデルが学習時には少なかった観測に遭遇する原因となる。受入検証では、まず行動インターフェースとシミュレーションを確認し、次に管理された外乱によって回復能力を試験し、タスク成功、衝突、制御の引き継ぎ、タイムアウトなどの異なる指標を記録すべきである。反復試験は、物体位置、照明、初期状態を網羅する必要があり、統計処理の前に失敗を削除してはならない。安全性指標とタスク指標は別々に報告しなければならない。[1] Diffusion Policy: Visuomotor Policy Learning via Action[3] RT-2: Vision-Language-Action Models Transfer Web Knowle
6. 再現記録にはハードウェアと運用条件を含めるべきである
ロボット、エンドエフェクタ、ファームウェア、カメラ、較正、制御周波数、データとモデルのバージョンを記録・保存する。実試験の環境変化はアルゴリズム間の差より大きい可能性があるため、順序の無作為化、同一の初期分布、十分な反復が必要である。再現を行う者は、一致する条件と異なる条件を明示し、不成功事例を登録すべきである。本稿は多峰性と制御上の制約を説明するにとどまり、ロボット実験を実施しておらず、実機での成功率を得たとも主張しない。[1] Diffusion Policy: Visuomotor Policy Learning via Action[2] Learning Fine-Grained Bimanual Manipulation with Low-Co[3] RT-2: Vision-Language-Action Models Transfer Web Knowle
主要な数式と導出
(1) 行動系列の条件付き分布。観測履歴、行動のパラメータ化、実行窓を指定する必要がある。
LaTeX
\pi_\theta(a_{t:t+H}\mid o_{\le t})(2) 行動のノイズ除去目的関数の模式的な表現であり、衝突率、安定性、実タスクの成功率と同等ではない。
LaTeX
\mathcal L=\mathbb E\|\epsilon-\epsilon_\theta(a^{(s)},s,o)\|_2^2(3) テール遅延とタイムスタンプを考慮する必要がある。平均の予算を満たすことは、制御の安全性の証明にはならない。
LaTeX
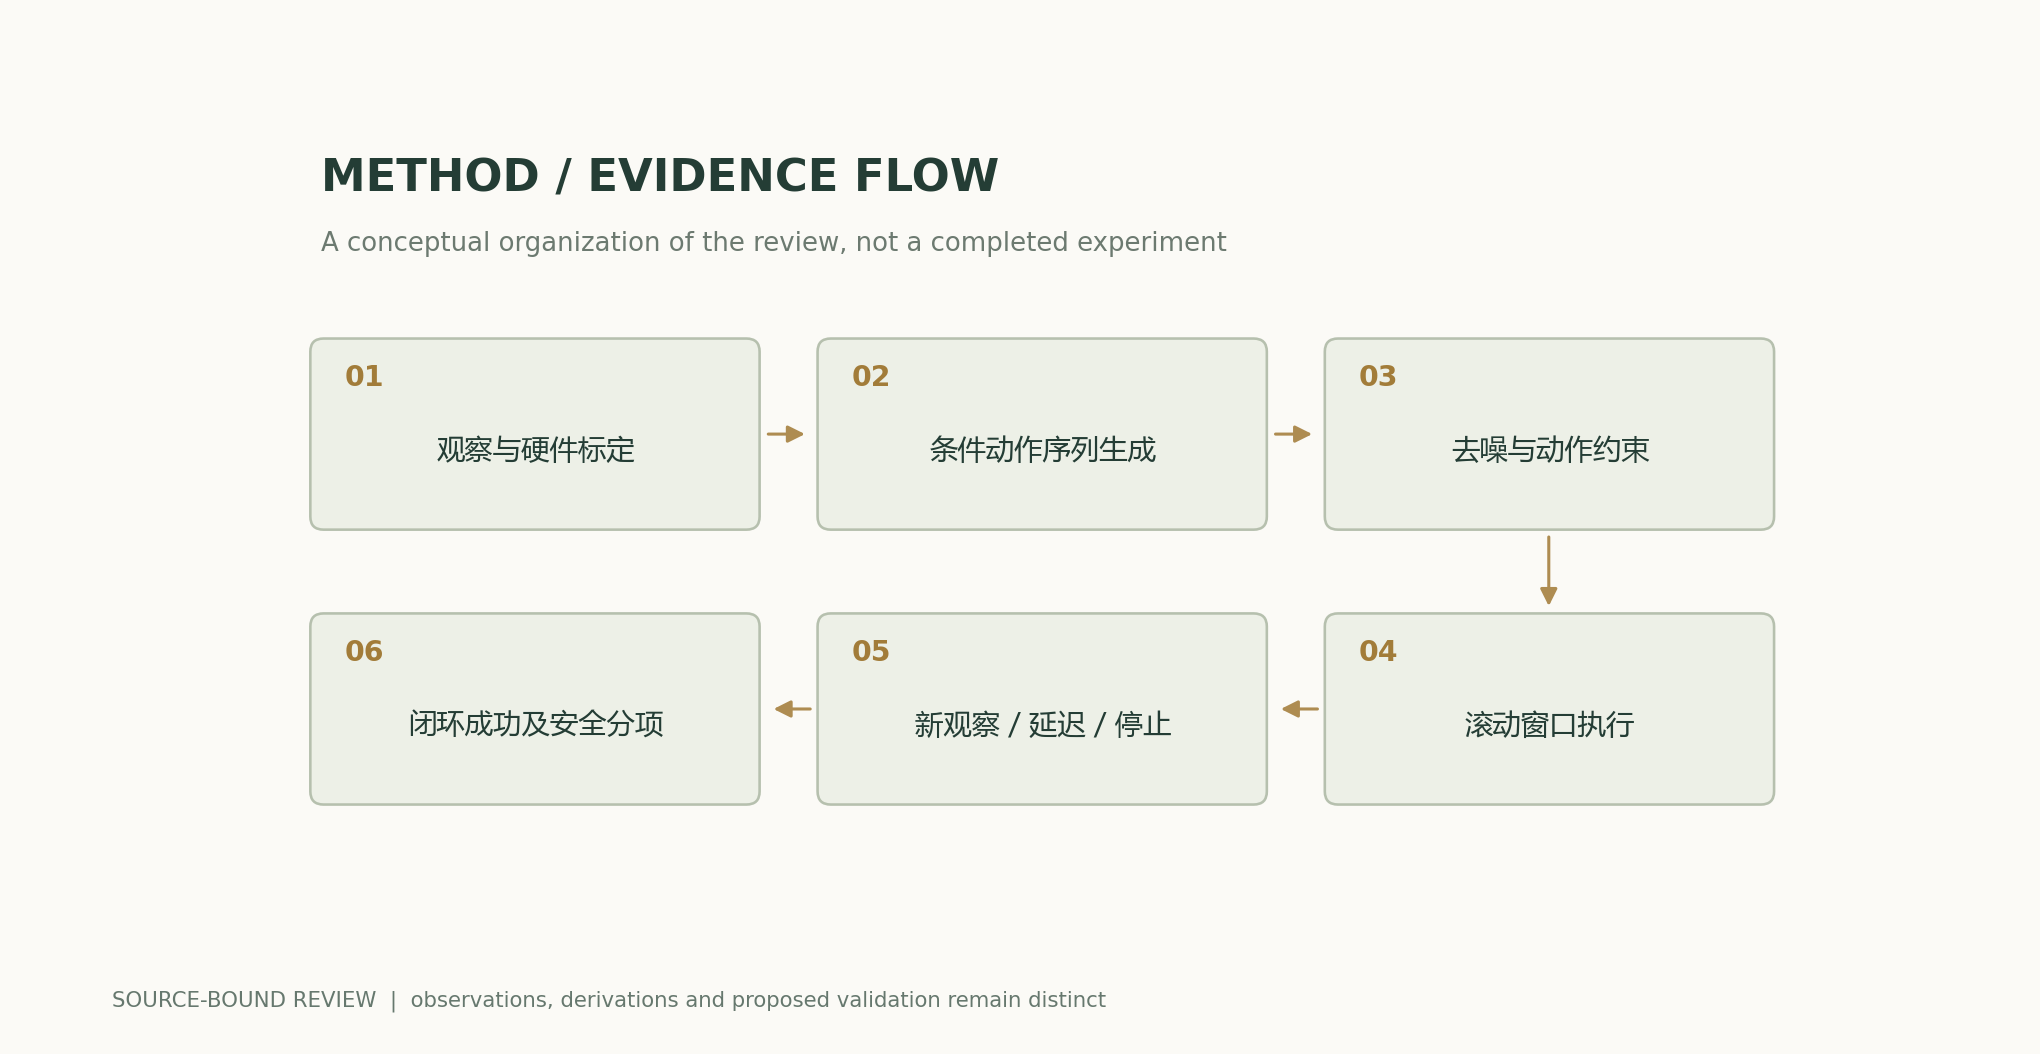
\tau_{\mathrm{sense}}+\tau_{\mathrm{infer}}+\tau_{\mathrm{comm}}+\tau_{\mathrm{prepare}}\le T_{\mathrm{budget}}手法とエビデンスの流れ
解析図と数値例
再計算可能な例題
対称な二峰性分布の平均は0であるが、0付近の密度は±1における密度よりはるかに低い。これは平均が実行可能なモードを代表しない可能性を示すものであり、拡散方策がロボットのいかなる制約も自動的に満たすことを証明するものではない。
手法の比較
| 手法または判断 | 統制変数と測定 | 失敗条件とその説明 |
|---|---|---|
| 多峰性方策 | 行動モード、単位、制約を確認する | 条件付き平均は実行可能な行動による裏付けを欠く可能性がある |
| リシーディングホライズン方式の実行 | 予測窓と実行窓を固定する | 長い窓とフィードバックの即時性にはトレードオフがある |
| タスク間転移 | プラットフォーム、較正、データの網羅範囲を確認する | 言語能力は物理的な信頼性と同義ではない |
| 実機の受入検証 | 成功、制御の引き継ぎ、衝突、タイムアウトを別々に記載する | オフライン誤差は閉ループ試験の代わりにはならない |
検証と実験の計画
- ハードウェア、較正、座標系、行動の単位、制御インターフェースのバージョンを固定する。
- デモンストレーションをタスクと環境に基づいて分割し、隣接する軌跡区間が学習集合とテスト集合にまたがらないようにする。
- まず出力範囲、制限、停止、シミュレーションを確認し、その後、管理された実機試験に進む。
- 再計画窓と実行窓を固定し、全段階のテール遅延と古くなった観測を測定する。
- 初期状態を無作為化して試験を反復し、成功、衝突、制御の引き継ぎ、タイムアウト、回復を独立して記録する。
- 環境の差異と失敗を公開し、選別した動画を試験全体の統計の代わりにしない。
適用範囲と限界
- 二峰性密度はロボット軌跡ではない。
- 実機ロボット実験は行っていない。
- 行動分布の品質は安全性を証明しない。
- プラットフォーム間の転移にはインターフェースの再確認が必要である。
一次資料と主張の対応
- Diffusion Policy: Visuomotor Policy Learning via Action Diffusion, , , , , , , · 2023-03-07Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware, , , · 2023-04-23Abstract; 原文方法、理论和实验章节见作者原始论文链接
- RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control, , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , -------------------------------------------------------------------------------- · 2023-07-28Abstract; 原文方法、理论和实验章节见作者原始论文链接
引用と原稿のエクスポート
著者、バージョン、出典
AI支援による研究レビュー。Codex(AI)が、記載した一次文献に基づいて執筆し、解析的導出を行った。本サイトには、本稿の独立した査読や独自のモデル実験の記録はない。
リーダーの性能改訂:直近のHEADリクエストが200を返し、ETagが一致する場合にも、既読ページを再利用する。本文、数式、出典、科学図のデータは前バージョンの内容を維持している。
概念的な表紙と科学的な図解は区別している。科学図は公開された数式と明示した仮定から計算し、原論文の結果にはすべて帰属を明記している。
著者、バージョン、訂正の記録 · /guides/robotics-diffusion-policy/v1/
表紙と科学図の出典 · データ、出典、仮定 · 公開・バージョン履歴
ソースの改訂: 6251a250b27bb8b449f59b392f81abd355383770