
摘要
机器人示范可能包含多种合理策略,直接平均动作可能落入示范概率很低的区域。扩散策略通过条件去噪建模动作序列,但闭环成功还取决于感知、时延、执行窗口及状态分布变化。本文比较生成式策略、跨任务数据和视觉语言动作方法的接口,提出从离线到受控实体测试的分阶段验收。图示是构造的双峰分布,不对应真实机器人轨迹。[1] Diffusion Policy: Visuomotor Policy Learning via Action[2] Learning Fine-Grained Bimanual Manipulation with Low-Co[3] RT-2: Vision-Language-Action Models Transfer Web Knowle
English abstract
Diffusion policies model conditional action sequences rather than a single mean action. We use a declared bimodal density to explain why averaging can produce a low-density action, then analyze receding-horizon execution and latency. The figure is not robot trajectory data. Offline prediction quality, closed-loop success and safety require separate validation.
1. 多模态动作不能随意用均值替代
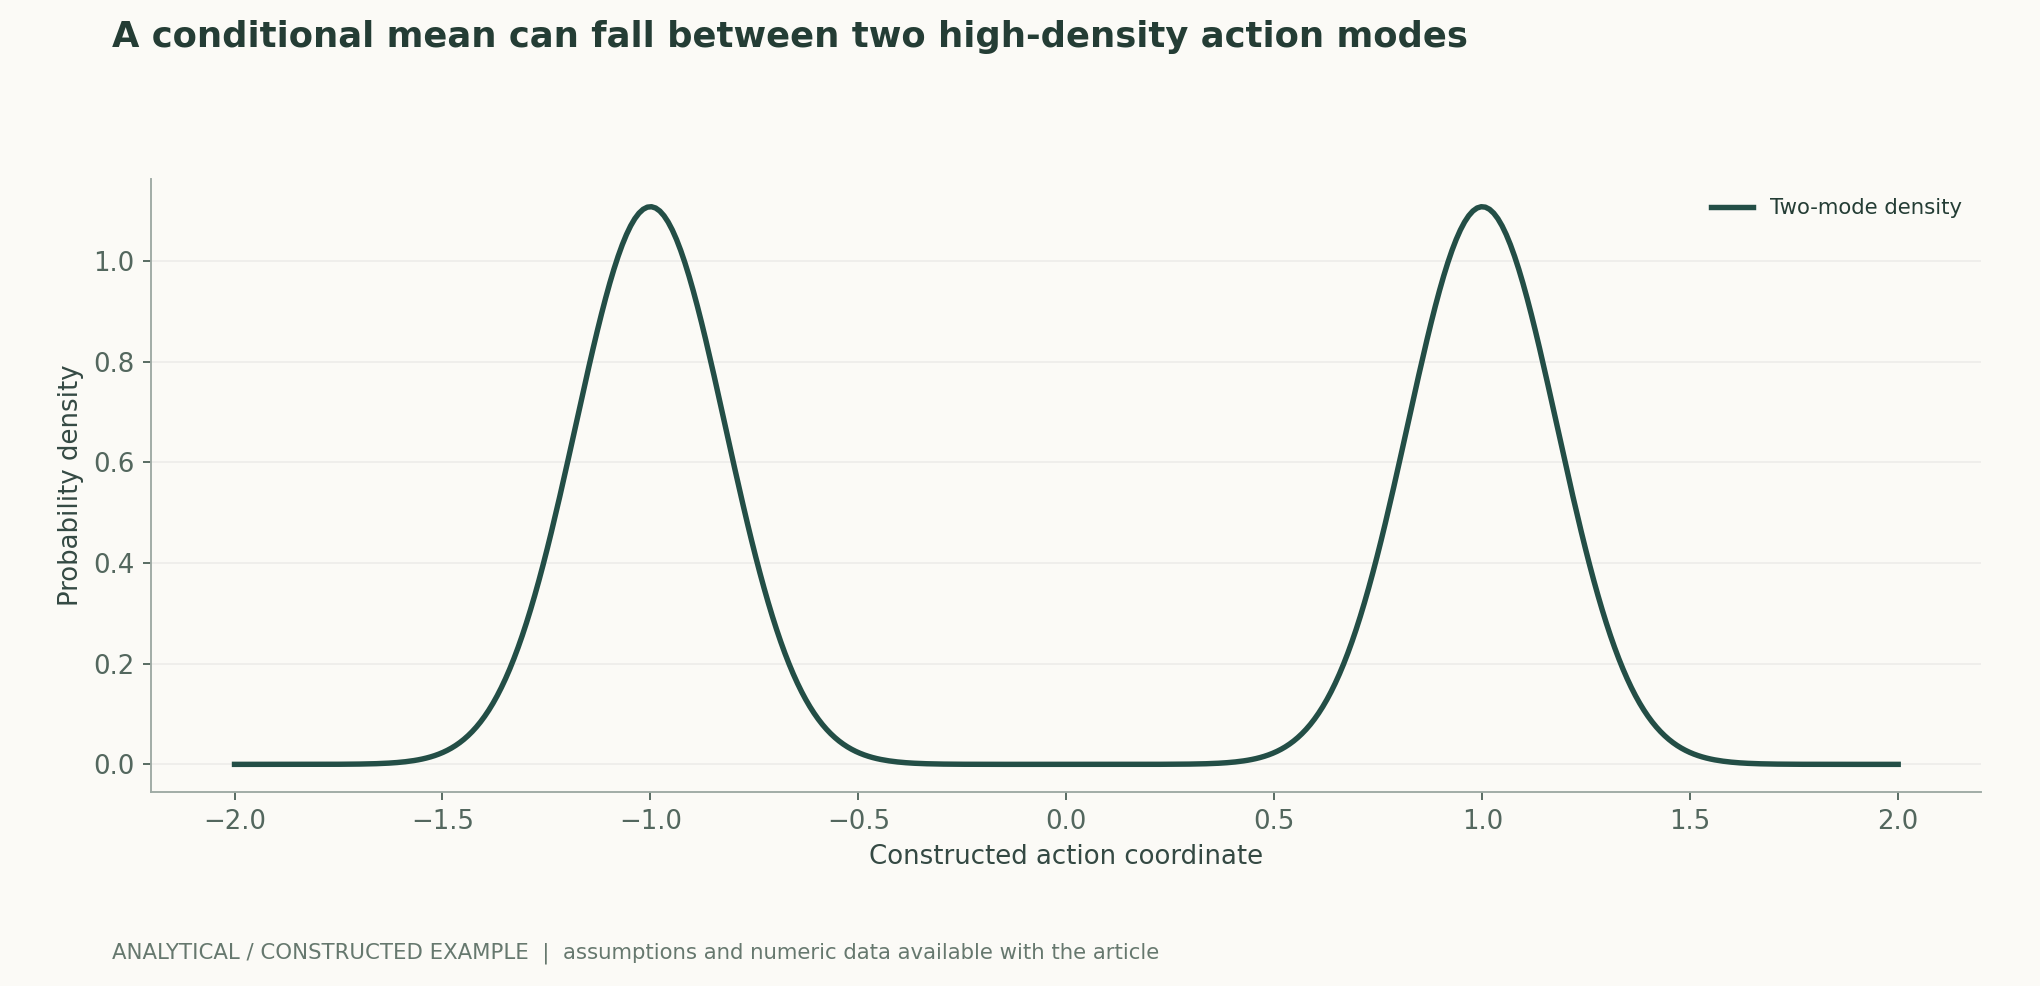
同一观察可能允许从物体左侧或右侧绕行,两种动作都合理,均值却可能指向中间障碍。这个例子说明平方误差回归的条件均值与可执行策略不同,但不是所有任务都需要多模态模型。扩散策略用条件去噪生成动作序列,可表达多个候选模式;实际是否覆盖示范、是否生成稳定动作,还需检查动作单位、限幅、坐标系和训练分布。[1] Diffusion Policy: Visuomotor Policy Learning via Action
2. 序列生成与闭环重规划共同工作
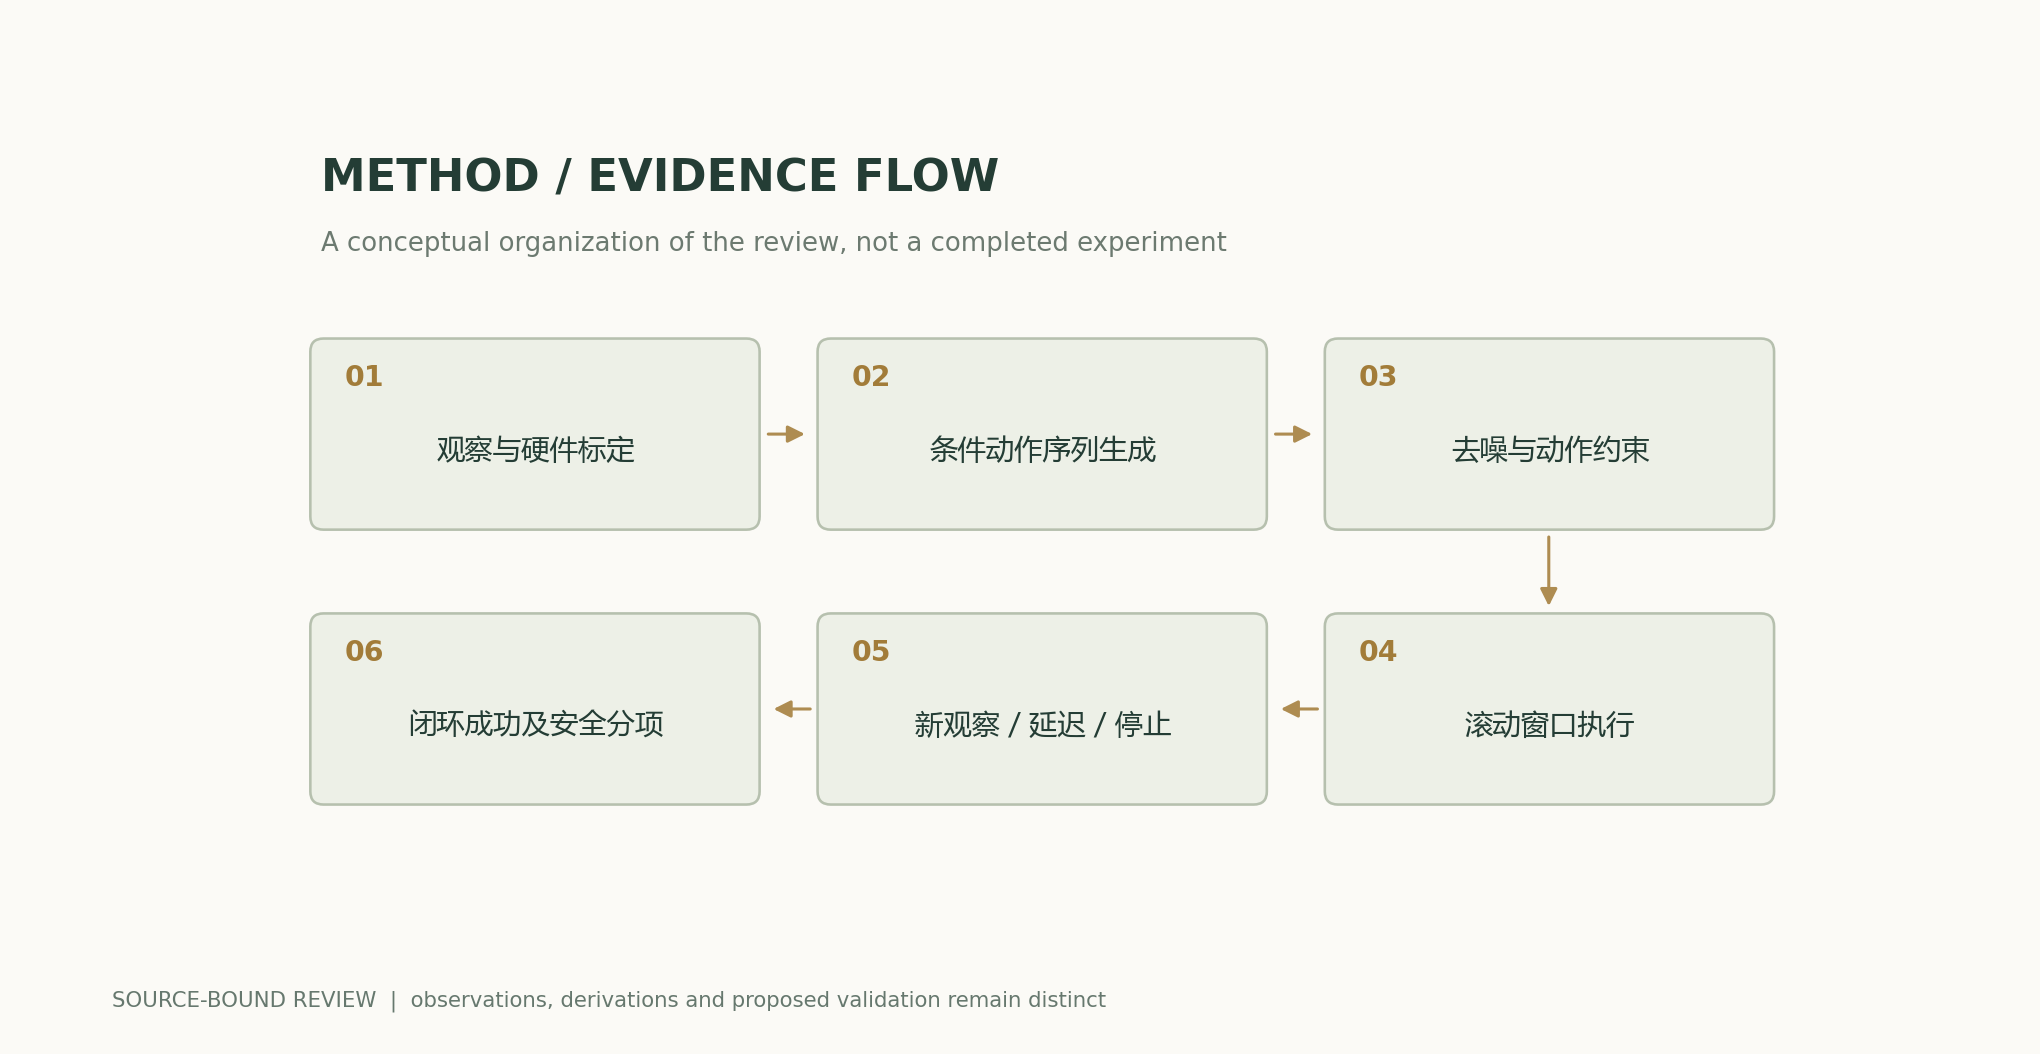
策略可以预测一个动作窗口,仅执行其中一部分后重新感知与规划。较长窗口减少重算频率,却可能让执行更久地依赖过时观察;较短窗口反应快,但增加推理和通信压力。去噪步数和输出长度都影响时延。比较时应固定感知频率、执行窗口和控制器接口,不能仅凭离线动作误差推断真实任务成功。[1] Diffusion Policy: Visuomotor Policy Learning via Action
3. 预训练与跨任务数据改变适用范围
RT-1研究规模化真实机器人任务数据与序列建模,RT-2将视觉语言知识与动作表示相联系。这些工作提供不同的表示和训练路径,但其数据、机器人、动作离散化和任务定义不同,不能按摘要数字直接排名。迁移到新平台前应明确动作语义、相机标定、工作空间和训练覆盖;文字理解能力不能替代物理动力学和执行可靠性。[2] Learning Fine-Grained Bimanual Manipulation with Low-Co[3] RT-2: Vision-Language-Action Models Transfer Web Knowle
4. 延迟预算是策略的一部分
传感、预处理、模型推理、通信和执行准备的总延迟必须与控制周期相容。平均延迟满足要求仍可能因尾延迟产生不稳定或安全风险。应测时间戳对齐、过期观察、丢帧和超时后的行为,并由独立限位与停止机制约束执行。本文没有连接机器人;任何真实测试都应先在合法受控环境进行,不能把生成动作直接当作安全指令。[1] Diffusion Policy: Visuomotor Policy Learning via Action[2] Learning Fine-Grained Bimanual Manipulation with Low-Co
5. 离线分数与闭环成功需要不同数据
离线验证只查看示范附近的动作预测,闭环误差会改变后续状态,导致模型遇到训练中较少的观察。验收应先核对动作接口与仿真,再以受控扰动测试恢复能力,记录任务成功、碰撞、接管和超时等不同指标。重复试验需覆盖物体位置、光照和初始状态,失败不能在统计前被删除。安全指标与任务指标必须分别报告。[1] Diffusion Policy: Visuomotor Policy Learning via Action[3] RT-2: Vision-Language-Action Models Transfer Web Knowle
6. 复现记录应包括硬件与操作条件
保存机器人、末端执行器、固件、相机、标定、控制频率、数据及模型版本。真实试验的环境变化可能大于算法差异,因此需要随机顺序、相同初始分布与足够重复。复现者应明确哪些条件匹配、哪些不同,登记未成功案例。本文只说明多模态与控制约束,没有完成机器人实验,也不声称获得实体成功率。[1] Diffusion Policy: Visuomotor Policy Learning via Action[2] Learning Fine-Grained Bimanual Manipulation with Low-Co[3] RT-2: Vision-Language-Action Models Transfer Web Knowle
核心公式与推导
(1) 对动作序列的条件分布;观察历史、动作参数化和执行窗口必须指定。
LaTeX
\pi_\theta(a_{t:t+H}\mid o_{\le t})(2) 动作去噪目标示意,不等同于碰撞率、稳定性或真实任务成功率。
LaTeX
\mathcal L=\mathbb E\|\epsilon-\epsilon_\theta(a^{(s)},s,o)\|_2^2(3) 需要考虑尾延迟和时间戳;满足平均预算不构成控制安全证明。
LaTeX
\tau_{\mathrm{sense}}+\tau_{\mathrm{infer}}+\tau_{\mathrm{comm}}+\tau_{\mathrm{prepare}}\le T_{\mathrm{budget}}方法与证据流程
解析图与数值示例
可复算例题
对称双峰分布的均值为0,但0附近密度远低于±1。它说明均值可能不代表可行模式,不证明扩散策略自动满足任何机器人约束。
方法比较
| 方法或判断 | 控制变量与测量 | 失效条件及解释 |
|---|---|---|
| 多模态策略 | 检查动作模式、单位与约束 | 条件均值可能缺乏可执行支持 |
| 滚动执行 | 固定预测和执行窗口 | 长窗口与反馈时效有折中 |
| 跨任务迁移 | 核对平台、标定和数据覆盖 | 语言能力不等于物理可靠性 |
| 实体验收 | 分列成功、接管、碰撞和超时 | 离线误差不能代替闭环测试 |
复核与实验方案
- 冻结硬件、标定、坐标系、动作单位与控制接口版本。
- 按任务和环境划分示范,防止相邻轨迹片段跨训练测试。
- 先核对输出范围、限位、停止与仿真,再进入受控实体试验。
- 固定重规划和执行窗口,测全部阶段的尾延迟及过期观察。
- 随机化初始状态并重复,独立记录成功、碰撞、接管、超时和恢复。
- 公开环境差异与失败,不以精选视频替代完整试验统计。
适用范围与局限
- 双峰密度不是机器人轨迹。
- 没有实体机器人实验。
- 动作分布质量不证明安全。
- 跨平台迁移需重新核对接口。
一手来源与主张对应
- Diffusion Policy: Visuomotor Policy Learning via Action Diffusion, , , , , , , · 2023-03-07Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware, , , · 2023-04-23Abstract; 原文方法、理论和实验章节见作者原始论文链接
- RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control, , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , -------------------------------------------------------------------------------- · 2023-07-28Abstract; 原文方法、理论和实验章节见作者原始论文链接
引用与文稿导出
BibTeXRISCSL JSONTXTArticle JSON
作者、版本与来源
AI辅助研究综述;Codex(AI)依据所列一手文献撰写并进行解析推导。 本站没有本篇独立同行评审或原创模型实验记录。
阅读器性能修订:新近 HEAD 返回 200 且 ETag 相同时也复用已读页面。正文、公式、来源和科学图的数据保持上一版本内容。
概念封面与科学图解分开;科学图由公开公式和明示假设计算,原始论文结果均注明归属。
作者、版本与更正记录 · /guides/robotics-diffusion-policy/v1/
Source revision: 6251a250b27bb8b449f59b392f81abd355383770