
Resumen
Los modelos meteorológicos deterministas pueden reducir el error medio, pero las decisiones reales suelen requerir conocer las probabilidades de los fenómenos, los riesgos conjuntos y las colas extremas. GenCast utiliza un conjunto estocástico para representar posibles trayectorias futuras; su artículo original lo compara con el ENS operativo para años, variables y plazos de predicción específicos. Estos resultados deben interpretarse junto con la inicialización, el número de miembros y el análisis de referencia. Apoyándose en GraphCast y WeatherBench 2, este artículo deriva el CRPS de conjuntos, el efecto de la correlación espacial sobre el riesgo agregado y las limitaciones de resolución de los conjuntos finitos para fenómenos raros. Proponemos un plan de validación centrado en bloques temporales emparejados y riesgos en aplicaciones posteriores. Las figuras no incluyen nuevas ejecuciones meteorológicas reales ni predicciones emitidas por este sitio.[1] Probabilistic weather forecasting with machine learning[2] GraphCast: Learning skillful medium-range global weathe[3] WeatherBench 2: A benchmark for the next generation of
Traducción del resumen original en inglés
Las predicciones meteorológicas probabilísticas deben representar trayectorias plausibles, distribuciones marginales calibradas y fenómenos conjuntos coherentes. Examinamos GenCast junto con GraphCast y WeatherBench 2, y después derivamos el CRPS de conjuntos y un contraejemplo de correlación espacial. Dos predicciones con distribuciones locales idénticas pueden implicar riesgos agregados muy distintos. Un ejemplo gaussiano analítico y un cálculo de cola para un conjunto finito motivan una evaluación emparejada por bloques temporales, con criterios separados para fenómenos extremos y equidad explícita en la inicialización.
1. Por qué la trayectoria óptima según el error cuadrático medio puede no ser una realización posible del tiempo real
GraphCast representa una vía eficiente para la predicción determinista a medio plazo, mientras que GenCast representa directamente la distribución condicional de los estados futuros. Si la trayectoria de una tormenta futura tiene dos ramificaciones posibles, la media condicional favorecida por la pérdida cuadrática media puede situarse entre ambas sin representar ninguna tormenta real. Por ello, este artículo distingue entre la media del conjunto y sus miembros: la media resulta adecuada para algunos criterios de estimación puntual, mientras que los miembros deben conservar una estructura espacial plausible para estimar trayectorias, extremos y cantidades agregadas. Aumentar las perturbaciones de inicialización de un modelo determinista tampoco recupera automáticamente todas las formas de distribución ausentes; es necesario comprobar directamente la estructura espectral y la coherencia temporal de los miembros.[2] GraphCast: Learning skillful medium-range global weathe[1] Probabilistic weather forecasting with machine learning
2. Los resultados originales de GenCast corresponden a una configuración de comparación bien definida
El artículo original de GenCast evalúa predicciones por conjuntos de 15 días, con intervalos de 12 horas y una malla de 0.25°, y utiliza un conjunto de 50 miembros para comparar múltiples objetivos en la prueba de 2019. El resultado del 97.2% en los 1320 elementos de la tabla de evaluación corresponde a combinaciones de variables, plazos y niveles, no a 1320 fenómenos meteorológicos nuevos mutuamente independientes; el artículo original advierte expresamente de la dependencia entre estos objetivos. Por tanto, este artículo conserva esa cifra como una conclusión específica del estudio fuente, sin reformularla como «exactitud para todo el tiempo futuro». La comparación también debe conservar la hora de inicialización de cada modelo, las observaciones disponibles y el análisis utilizado como referencia de verdad.[1] Probabilistic weather forecasting with machine learning
3. Derivación de este artículo: el CRPS evalúa tanto la localización como la dispersión
El CRPS de conjuntos puede expresarse como la distancia absoluta media entre los miembros y la observación, menos la mitad de la distancia media entre pares de miembros. El primer término penaliza el alejamiento de la observación, mientras que el segundo impide concentrar incondicionalmente toda la probabilidad en un único punto; conjuntamente favorecen la distribución correcta en términos de esperanza. Este artículo utiliza una expresión gaussiana analítica para mostrar los distintos costes del sesgo de la media y de los conjuntos demasiado estrechos o demasiado amplios, y señala la diferencia entre estimar con un número finito de miembros y puntuar una distribución ideal. Un conjunto más disperso no es necesariamente mejor, ni uno más estrecho es necesariamente más preciso. Deben realizarse comparaciones emparejadas sobre las mismas muestras de verificación para no confundir diferencias en la dificultad meteorológica con diferencias entre métodos.作者分析与复核建议 / Author analysis
4. La calibración y la nitidez deben interpretarse conjuntamente
GenCast y WeatherBench 2 utilizan diversos diagnósticos probabilísticos, incluida la relación entre la dispersión del conjunto y el error. La calibración exige que las probabilidades sean compatibles con las frecuencias de los fenómenos, mientras que la nitidez describe cuánto se concentra la distribución predictiva; una distribución concentrada solo resulta útil cuando la calibración es suficiente. Un sistema que siempre proporciona la distribución climatológica puede estar razonablemente calibrado y, aun así, aportar muy poca información sobre casos concretos. Este artículo recomienda representar la fiabilidad por estación, región, plazo e intensidad del fenómeno, indicando también el tamaño muestral. Una buena calibración global no descarta un exceso sistemático de confianza en una zona marítima, una clase de extremos o un plazo específico.[1] Probabilistic weather forecasting with machine learning[3] WeatherBench 2: A benchmark for the next generation of
5. Contraejemplo de este artículo: la corrección local no garantiza un riesgo conjunto correcto
Supongamos que los errores normalizados de potencia eólica en dos ubicaciones tienen, cada uno, media cero y varianza uno, pero un coeficiente de correlación ρ. La varianza del error total es 2+2ρ: vale 1 cuando ρ=−0.5 y 3.6 cuando ρ=0.8, aunque las distribuciones locales de ambas ubicaciones sean idénticas. Este ejemplo analítico muestra que comprobar únicamente las distribuciones marginales de cada punto de malla puede pasar por alto dependencias importantes para redes eléctricas, cuencas hidrográficas o trayectorias de tormentas. Este artículo no simula una red eléctrica real, sino que demuestra la necesidad de una evaluación conjunta. Deben conservarse las relaciones espaciotemporales dentro de los miembros antes de calcular indicadores agregados; reordenar previamente los miembros de forma independiente en cada ubicación destruiría la estructura de correlación.作者分析与复核建议 / Author analysis
6. Derivación de este artículo: la ausencia en un conjunto finito no implica una probabilidad nula
Cuando un fenómeno tiene una probabilidad real p, la probabilidad de que no aparezca en ninguno de M miembros independientes es (1−p) elevado a M. Con p=1% y M=50, esa probabilidad sigue siendo aproximadamente 60.5%; por tanto, «ausente del conjunto» no puede interpretarse directamente como «imposible». Los miembros reales pueden estar correlacionados, lo que reduce aún más la información efectiva de la cola. La figura muestra la probabilidad de no observar el fenómeno para distintos tamaños de conjunto y señala por separado el incremento de probabilidad empírica 1/M. La investigación debe distinguir el sesgo de cola del propio modelo de la resolución de muestreo y equiparar el número de miembros al comparar; muestrear más miembros de un sistema no permite afirmar que modele la distribución con mayor precisión.作者分析与复核建议 / Author analysis
7. La equidad en la inicialización determina si la comparación responde a la misma pregunta
WeatherBench 2 subraya la coherencia entre las predicciones basadas en datos y las físicas en cuanto a inicialización, análisis de referencia y remallado. El reanálisis puede utilizar una ventana de información distinta de la disponible en el momento operativo; si no se especifican las observaciones disponibles, la ventaja fuera de línea puede incorporar información adicional. Este artículo recomienda registrar por separado la hora de inicialización, el cierre de datos, la duración de la inferencia y la hora de entrega del producto; el plazo que realmente recibe el usuario debe calcularse desde el momento en que el producto está disponible. El remallado y el análisis de referencia deben fijarse, conservando explicaciones específicas para variables con mayor incertidumbre de medición, como la precipitación, el viento cerca de la superficie o las variables en terrenos complejos.[3] WeatherBench 2: A benchmark for the next generation of [1] Probabilistic weather forecasting with machine learning
8. Los fenómenos extremos requieren criterios de evaluación independientes y bloques temporales
El calor extremo, las trayectorias de tormentas y las cantidades agregadas regionales presentan estructuras estadísticas diferentes. Probar numerosos umbrales y publicar después solo el resultado más significativo genera sesgo de selección. Este artículo recomienda prerregistrar umbrales y regiones, efectuar remuestreo emparejado utilizando episodios meteorológicos continuos como bloques temporales y comunicar por separado la detección de fenómenos, las falsas alarmas y la calibración. Una tormenta que abarca decenas de instantes y puntos de malla no equivale a decenas de fenómenos extremos independientes. Para fenómenos raros, los intervalos pueden ser muy amplios y deben conservarse fielmente; a veces la conclusión contrastable es «la evidencia actual es insuficiente», en lugar de presentar diferencias no significativas como equivalencia absoluta.作者分析与复核建议 / Author analysis
9. De las puntuaciones al valor para la toma de decisiones
Una misma predicción probabilística tiene distinto valor para usuarios con diferentes estructuras de pérdidas. Las tareas con costes de preparación bajos y pérdidas elevadas por fenómenos no detectados adoptarán umbrales de actuación menores; otras se preocuparán más por las falsas alarmas. Este artículo propone comunicar tanto las puntuaciones probabilísticas estándar como curvas de coste–pérdida prerregistradas, calculadas con el mismo conjunto de predicciones fijadas. Los umbrales y las pérdidas deben proceder de contextos de uso definidos, no elegirse para destacar las ventajas del modelo. Si un modelo solo mejora el CRPS marginal, pero empeora el riesgo agregado o el rendimiento en ciertos umbrales de decisión, esa limitación debe formar parte de los resultados principales.作者分析与复核建议 / Author analysis
Suplemento técnico A · Difusión condicional y trayectorias autorregresivas
GenCast muestrea la distribución condicional del siguiente estado meteorológico y utiliza después el estado obtenido en los pasos posteriores; por ello, la incertidumbre de la trayectoria incorpora la generación condicional en cada paso y la retroalimentación de la historia previa. Una muestra no es una barra de error de un parámetro fijo, sino una trayectoria espaciotemporal con correlación interna. Este artículo recomienda conservar la identidad de los miembros de trayectoria, las semillas aleatorias y las variables de cada instante, y comprobar si tras varios pasos aparece energía de alta frecuencia poco plausible o deriva. Una excelente puntuación en un solo paso no garantiza trayectorias largas plausibles; del mismo modo, una media del conjunto más suave no implica que todos los miembros carezcan de estructura. Ambos aspectos deben examinarse por separado.[1] Probabilistic weather forecasting with machine learning
Suplemento técnico B · La evaluación de conjuntos finitos implica elegir un estimador
El término de distancias entre pares del CRPS de la distribución empírica utiliza como denominador M al cuadrado e incluye los términos diagonales nulos. Si se pretende obtener una corrección insesgada de la puntuación poblacional de la distribución predictiva continua subyacente, se utiliza otra normalización para muestras finitas. Ambas se aproximan en conjuntos grandes, pero en conjuntos pequeños la diferencia puede afectar a la comparación. Este artículo utiliza de manera fija la puntuación de la distribución empírica escrita en la ecuación de la página y exige igualar el número de miembros entre sistemas; si se emplea una versión corregida, deben especificarse su nombre y su fórmula. No puede aumentarse el número de miembros y cambiarse a la vez el estimador para después atribuir toda la variación de la puntuación a una mejora del modelo.作者分析与复核建议 / Author analysis
Suplemento técnico C · Los espectros espaciales y las probabilidades de fenómenos extremos son comprobaciones complementarias
El realismo visual o un espectro de alta frecuencia plausible indican que los miembros conservan ciertas estructuras, pero no demuestran que la frecuencia de superación de umbrales extremos sea correcta. A la inversa, la calibración de las frecuencias marginales de extremos también puede lograrse con muestras espacialmente incoherentes. Este artículo propone comprobar conjuntamente los espectros, la continuidad de las trayectorias y la fiabilidad de los fenómenos utilizando exactamente los mismos miembros. Para totales de cuenca o región, primero debe calcularse el agregado de cada miembro y después evaluarse la distribución agregada; promediar primero los miembros en un solo mapa pierde información sobre fenómenos no lineales, especialmente superaciones de umbral y máximos.作者分析与复核建议 / Author analysis
Suplemento técnico D · El umbral de coste–pérdida procede del contexto de uso
En el problema más sencillo de actuación binaria, la preparación cuesta C y la ocurrencia del fenómeno sin preparación causa una pérdida L. Si la preparación evita esa pérdida, el umbral de actuación corresponde a una probabilidad pronosticada mayor que C/L. Esta derivación muestra que una misma predicción puede aportar distinto valor a distintos usuarios; también recuerda que la función de coste debe proceder de la tarea real, no diseñarse a medida del modelo. Si la preparación no elimina completamente la pérdida o existen restricciones de capacidad de recursos, la relación del umbral cambia. La investigación debe explicitar primero los supuestos de decisión, calcular después las curvas y conservar todos los rangos de coste previstos, en lugar de mostrar solo el intervalo más favorable.作者分析与复核建议 / Author analysis
10. Conclusión: la predicción meteorológica probabilística es una tarea definida conjuntamente por distribuciones y decisiones
La importancia de los modelos meteorológicos generativos va más allá de producir más mapas rápidamente: consiste en proporcionar conjuntos de futuros posibles que sustenten la evaluación del riesgo. Desde las perspectivas de la puntuación, la dependencia y la resolución de la cola, este artículo muestra que el error medio, la calibración, el realismo y el riesgo conjunto no son intercambiables. Las publicaciones abiertas deben conservar los miembros completos, las condiciones de inicialización, las unidades de las variables y el código de evaluación, y vincular cada resultado de las fuentes con su configuración original de prueba. Esta cadena de evidencia permite que las mejoras posteriores respondan a preguntas más concretas: qué tipo de incertidumbre mejora el modelo y en qué condiciones ayuda realmente a decidir.作者分析与复核建议 / Author analysis
Ecuaciones fundamentales y derivaciones
(1) CRPS de conjuntos para la distribución empírica; no es el mismo estimador que la corrección insesgada de la puntuación poblacional para un conjunto finito.
LaTeX
\operatorname{CRPS}_M=\frac1M\sum_i|x_i-y|-\frac1{2M^2}\sum_{i,j}|x_i-x_j|(2) Puntuación analítica de una distribución predictiva gaussiana, σ>0; utilizada como ejemplo de calibración cuyo cálculo puede reproducirse.
LaTeX
\operatorname{CRPS}(\mathcal N(\mu,\sigma^2),y)=\sigma\left[z(2\Phi(z)-1)+2\phi(z)-\frac1{\sqrt\pi}\right],\quad z=\frac{y-\mu}{\sigma}(3) La igualdad de las varianzas marginales no determina el riesgo agregado; la dependencia conjunta debe medirse por separado.
LaTeX
\operatorname{Var}(X_1+X_2)=\sigma_1^2+\sigma_2^2+2\rho\sigma_1\sigma_2(4) Probabilidad de no observar un fenómeno raro bajo el supuesto de miembros independientes; no implica que los miembros de los conjuntos meteorológicos reales sean completamente independientes.
LaTeX
P(N_{\mathrm{event}}=0)=(1-p)^MFlujo de métodos y evidencia
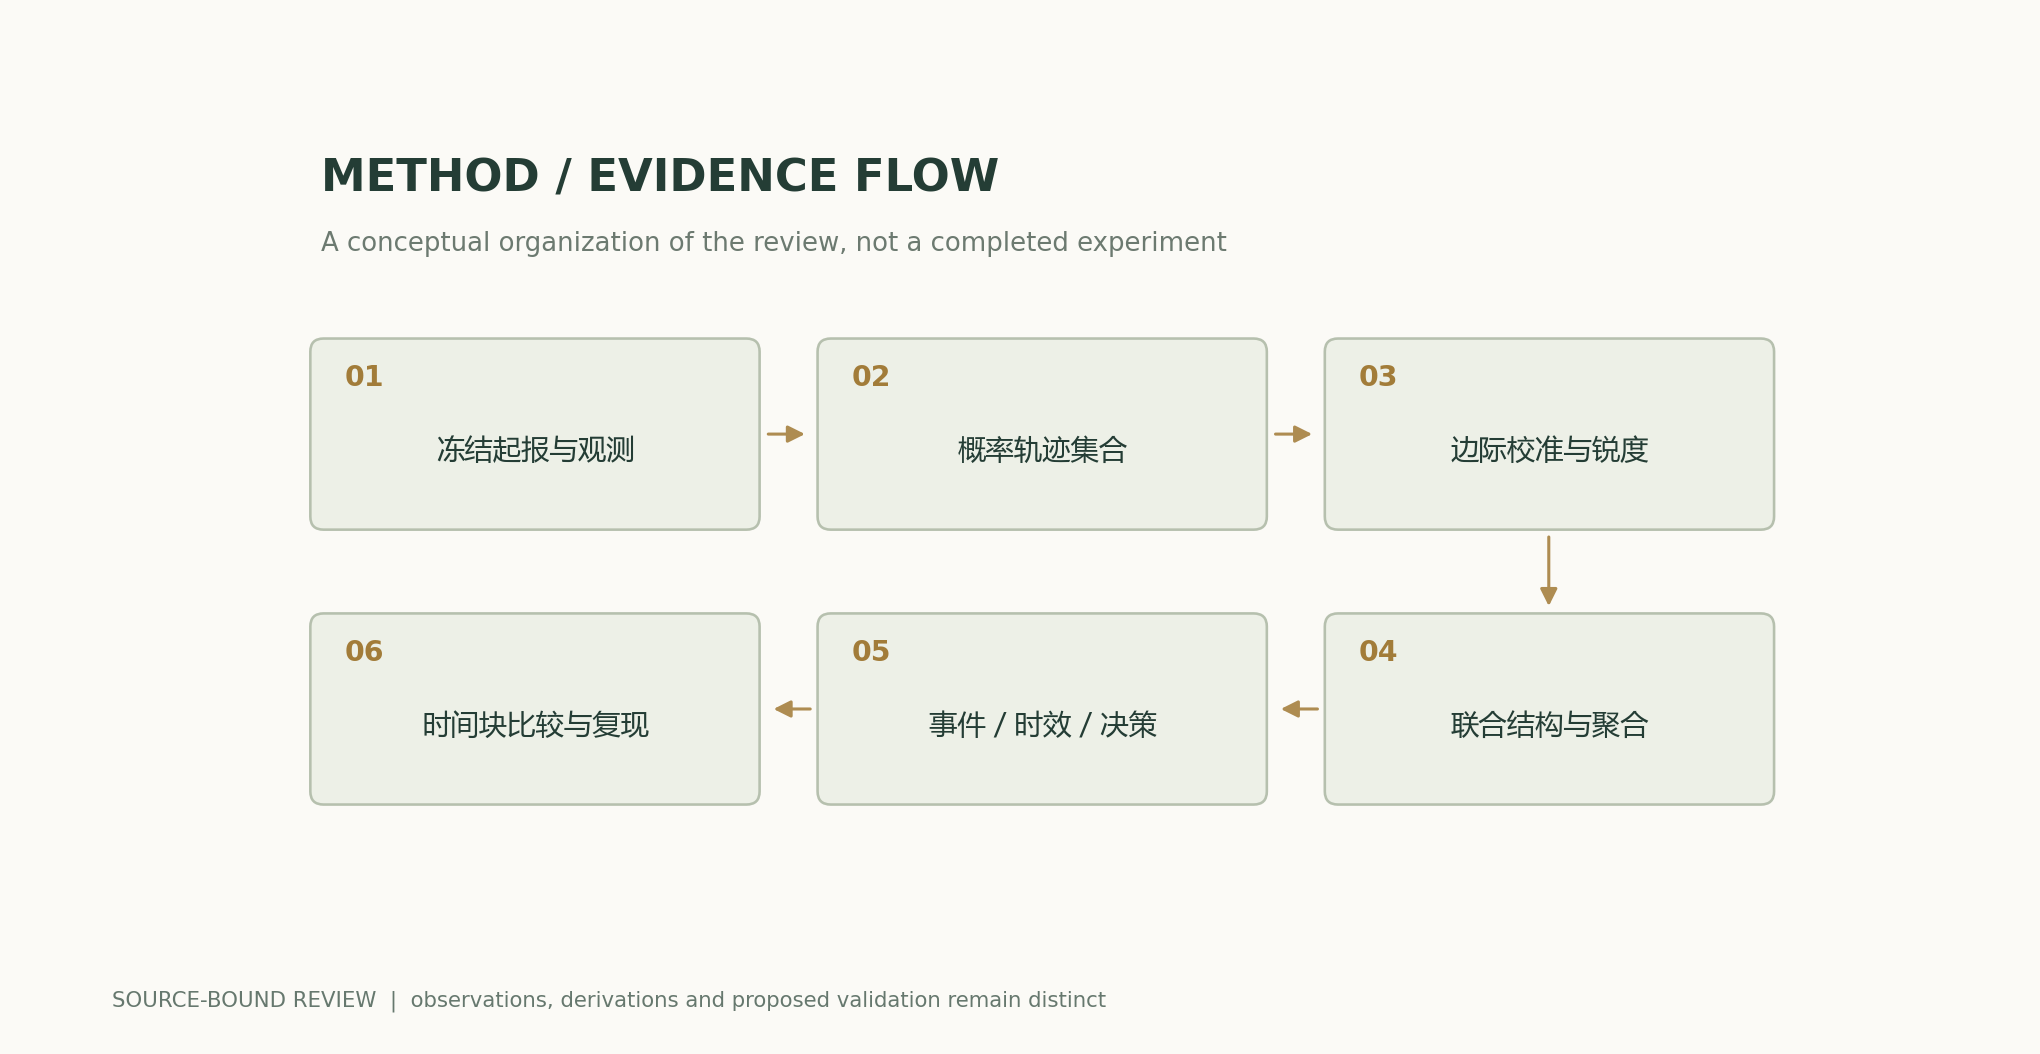
Figuras analíticas y ejemplos numéricos
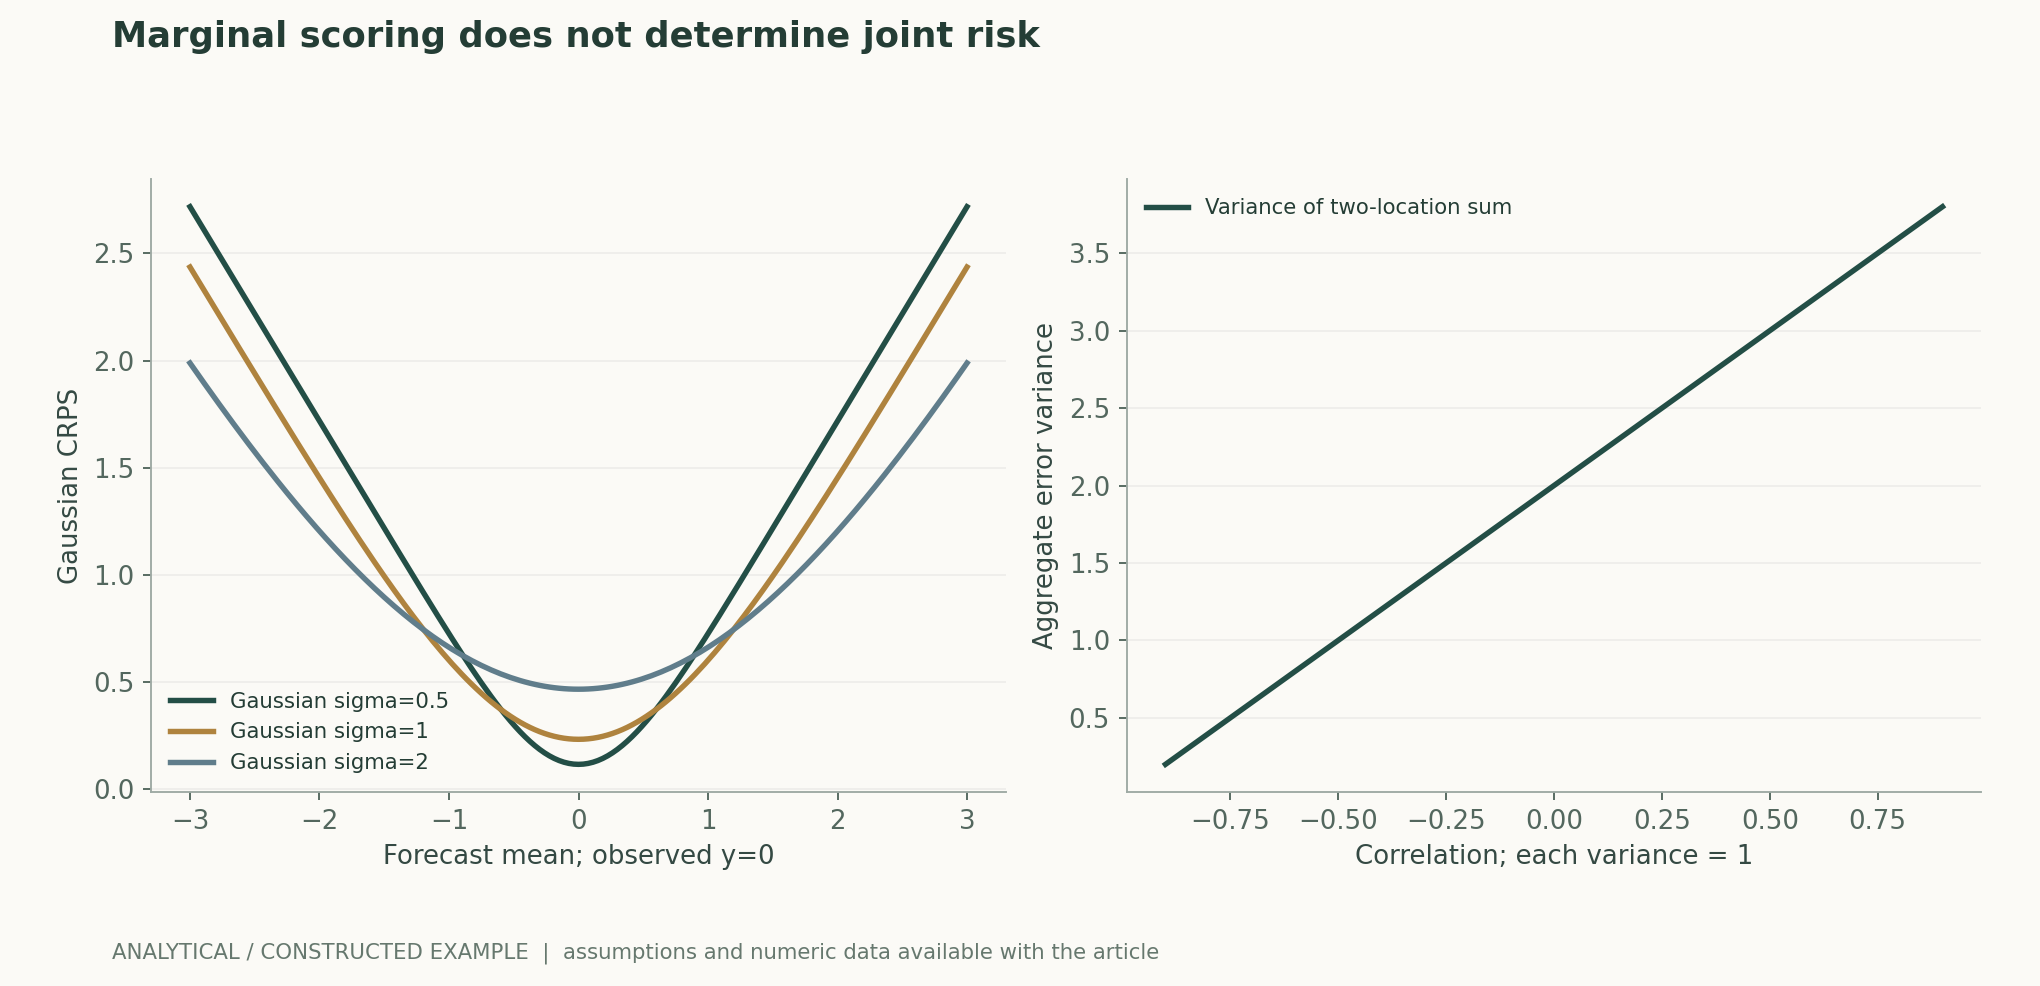
Ejemplo resuelto cuyo cálculo puede reproducirse
Para una gaussiana insesgada de varianza unitaria, cuando y=0, CRPS=(sqrt(2)-1)/sqrt(pi)≈0.233695; con rho=-0.5 y 0.8, las varianzas totales son 1 y 3.6, respectivamente; la probabilidad de que 50 miembros independientes no muestren un fenómeno de probabilidad 1% es aproximadamente 0.605006.
Comparación de métodos
| Capacidad | Medición adecuada | Interpretación errónea habitual |
|---|---|---|
| Estimación puntual | Error de la media y sesgo | Representa todas las trayectorias posibles |
| Distribución marginal | CRPS, fiabilidad y nitidez | La calibración global sustituye a la calibración estratificada |
| Estructura de los miembros | Espectros, trayectorias y continuidad temporal | La nitidez visual implica la distribución real |
| Riesgo conjunto | Agregación dentro del mismo miembro y dependencia entre fenómenos | La corrección en cada punto de malla implica corrección conjunta |
| Cola extrema | Umbrales fijos, número de fenómenos e intervalos | Ningún miembro muestra el fenómeno, por tanto su probabilidad es nula |
| Uso práctico | Cierre de datos, latencia y coste–pérdida | La velocidad de inferencia equivale a la oportunidad temporal de todo el proceso |
Plan de verificación y experimentación
- Fijar la inicialización, el cierre de datos, el análisis de referencia y las reglas de remallado.
- Igualar el número de miembros, los plazos y los conjuntos de variables; no combinar criterios incompatibles.
- Prerregistrar criterios de evaluación como CRPS, calibración estratificada, espectros y riesgo conjunto.
- Conservar íntegramente los identificadores de los miembros y sus relaciones temporales, evitando reordenarlos de forma independiente en cada ubicación.
- Realizar comparaciones emparejadas por bloques temporales definidos por episodios meteorológicos, contando muestras independientes por fenómenos y no por puntos de malla.
- Fijar los umbrales de extremos y los costes de actuación, y comunicar todas las comparaciones previstas.
- Evaluar por separado la sensibilidad de las estimaciones de fenómenos raros al número de miembros y a su correlación.
- Publicar las predicciones fijadas y el código de evaluación, distinguiendo los resultados originales, los análisis de este artículo y las predicciones operativas no ejecutadas.
Ámbito de aplicación y limitaciones
- La gaussianidad, la correlación entre dos ubicaciones y la independencia de los miembros son supuestos analíticos.
- Este artículo no ejecutó GenCast ni produjo predicciones meteorológicas reales.
- Los objetivos de la tabla de evaluación original están correlacionados y no pueden interpretarse como tareas binomiales independientes.
- Una prueba retrospectiva de un solo año no representa todos los climas y extremos futuros.
- La información disponible para el reanálisis y los productos operativos difiere y debe verificarse en el contexto real.
Evidencia de los estudios originales y su ámbito de aplicación
| Resultado del estudio original | Ámbito de aplicación | Fuente y ubicación |
|---|---|---|
| En la comparación de 2019, el artículo original informa de un rendimiento superior en el 97.2% de los 1320 elementos de la tabla de evaluación. | Las combinaciones de variables, plazos y niveles presentan dependencia; no se trata de exactitud futura. | Predicción meteorológica probabilística mediante aprendizaje automáticoResumen; Modelos de referencia; Habilidad predictiva del conjunto |
| Predicción global determinista eficiente a medio plazo. | La habilidad de predicción puntual no proporciona automáticamente una distribución de probabilidad calibrada. | GraphCast: aprendizaje de una predicción meteorológica global hábil a medio plazoResumen de la prepublicación del estudio original |
| Proporciona datos unificados y un marco de comparación con múltiples métricas. | La inicialización y los criterios de verdad de referencia aún deben comprobarse modelo por modelo. | WeatherBench 2: un banco de pruebas para la próxima generación de modelos meteorológicos globales basados en datosDiseño de la evaluación |
Preguntas de investigación que merece la pena contrastar
- ¿Las mejoras en las puntuaciones marginales se traducen en mejoras del riesgo agregado calculado dentro del mismo miembro?
- Con el mismo presupuesto de miembros, ¿qué fenómenos extremos siguen limitados por la resolución del muestreo?
- ¿Cuánta ventaja fuera de línea se conserva al calcular el plazo desde la hora de entrega real?
Fuentes primarias y afirmaciones correspondientes
- Probabilistic weather forecasting with machine learningPrice et al. · 2024-12-04Abstract; 2019 test period, 50-member comparison, CRPS scorecard and dependent verification targets.
- GraphCast: Learning skillful medium-range global weather forecastingLam et al. · 2022-12-24Authors' primary preprint; deterministic medium-range forecasts and verification scope; linked Science version.
- WeatherBench 2: A benchmark for the next generation of data-driven global weather modelsRasp et al. · 2023-08-29Primary benchmark specification: initialization, regridding, reference analyses and multiple diagnostic metrics.
Citación y exportación del manuscrito
BibTeXRISCSL JSONTXTArtículo en JSON
Autoría, versión y fuentes
Revisión de investigación documentada y análisis original redactados por Codex (IA). Los experimentos de los artículos originales corresponden a sus equipos de investigación; los cálculos de este artículo solo comprueban las ecuaciones enumeradas y los supuestos explícitos. Este sitio aún no dispone de una revisión por pares independiente de este artículo ni de registros de experimentos originales con modelos, clínicos o físicos.
Primera publicación: especial en profundidad sobre IA y descubrimiento científico; se conservan las fuentes de cada sección y los límites entre la evidencia de los estudios originales y el análisis del autor.
La portada conceptual fue generada por ImageGen. Las figuras científicas se trazaron con el código y los archivos numéricos que acompañan al artículo; sus pies explican, elemento por elemento, los supuestos y criterios de medición.
Fuentes de la portada y de las figuras científicas · Datos, fuentes y supuestos · Python · Código para reproducir los cálculos · Historial de publicación y versiones
Revisión de la fuente: b7b48f7205d705b2a3d3e8de0be5e1b458e4869c