
摘要
确定性天气模型可以降低平均误差,但真实决策常需要知道事件概率、联合风险与极端尾部。GenCast 用随机集合表示可能的未来轨迹,其原文在特定年份、变量与时效上与 operational ENS 比较;这些结果必须与初始化、成员数和参考分析一起解读。本文结合 GraphCast 与 WeatherBench 2,推导集合 CRPS、空间相关对聚合风险的影响,以及有限集合对罕见事件的分辨限制。我们提出以配对时间块和下游风险为核心的验证方案,图中不包含真实天气重跑或本站预报。[1] Probabilistic weather forecasting with machine learning[2] GraphCast: Learning skillful medium-range global weathe[3] WeatherBench 2: A benchmark for the next generation of
English abstract
Probabilistic weather forecasts must represent plausible trajectories, calibrated marginals and coherent joint events. We examine GenCast alongside GraphCast and WeatherBench 2, then derive ensemble CRPS and a spatial-correlation counterexample. Two forecasts with identical local distributions can imply very different aggregate risks. An analytical Gaussian example and finite-ensemble tail calculation motivate paired, temporally blocked evaluation with separate extreme-event endpoints and explicit initialization fairness.
1. 均方最优轨迹为何可能不是真实天气的一种
GraphCast 代表高效的中期确定性预测路线;GenCast 则直接表示未来状态的条件分布。若未来风暴路径有两个可能分支,均方损失偏好的条件均值可能落在两条路径中间,却不是任一真实风暴。本文据此区分集合均值与集合成员:均值适合某些点估计终点,成员应保持合理空间结构,用于估计路径、极端与聚合量。增加确定性模型的初始化扰动也不自动恢复所有缺失的分布形状,需直接检验成员的谱结构和时序一致性。[2] GraphCast: Learning skillful medium-range global weathe[1] Probabilistic weather forecasting with machine learning
2. GenCast 的原文结果属于明确的比较设置
GenCast 原文评估 15 日、12 小时间隔、0.25° 网格的集合预测,并在 2019 测试中以 50 成员集合进行多目标比较。97.2% 的 1320 项 scorecard 结果涉及变量、时效和层次组合,而不是 1320 个相互独立的新天气事件;原文明确提醒这些目标存在依赖。本文因此将这一数字保存为来源研究的特定结论,不改写成“未来所有天气正确率”。比较还需保留各模型的初始化时间、可用观测与分析真值。[1] Probabilistic weather forecasting with machine learning
3. 本文推导:CRPS 同时评价位置与离散程度
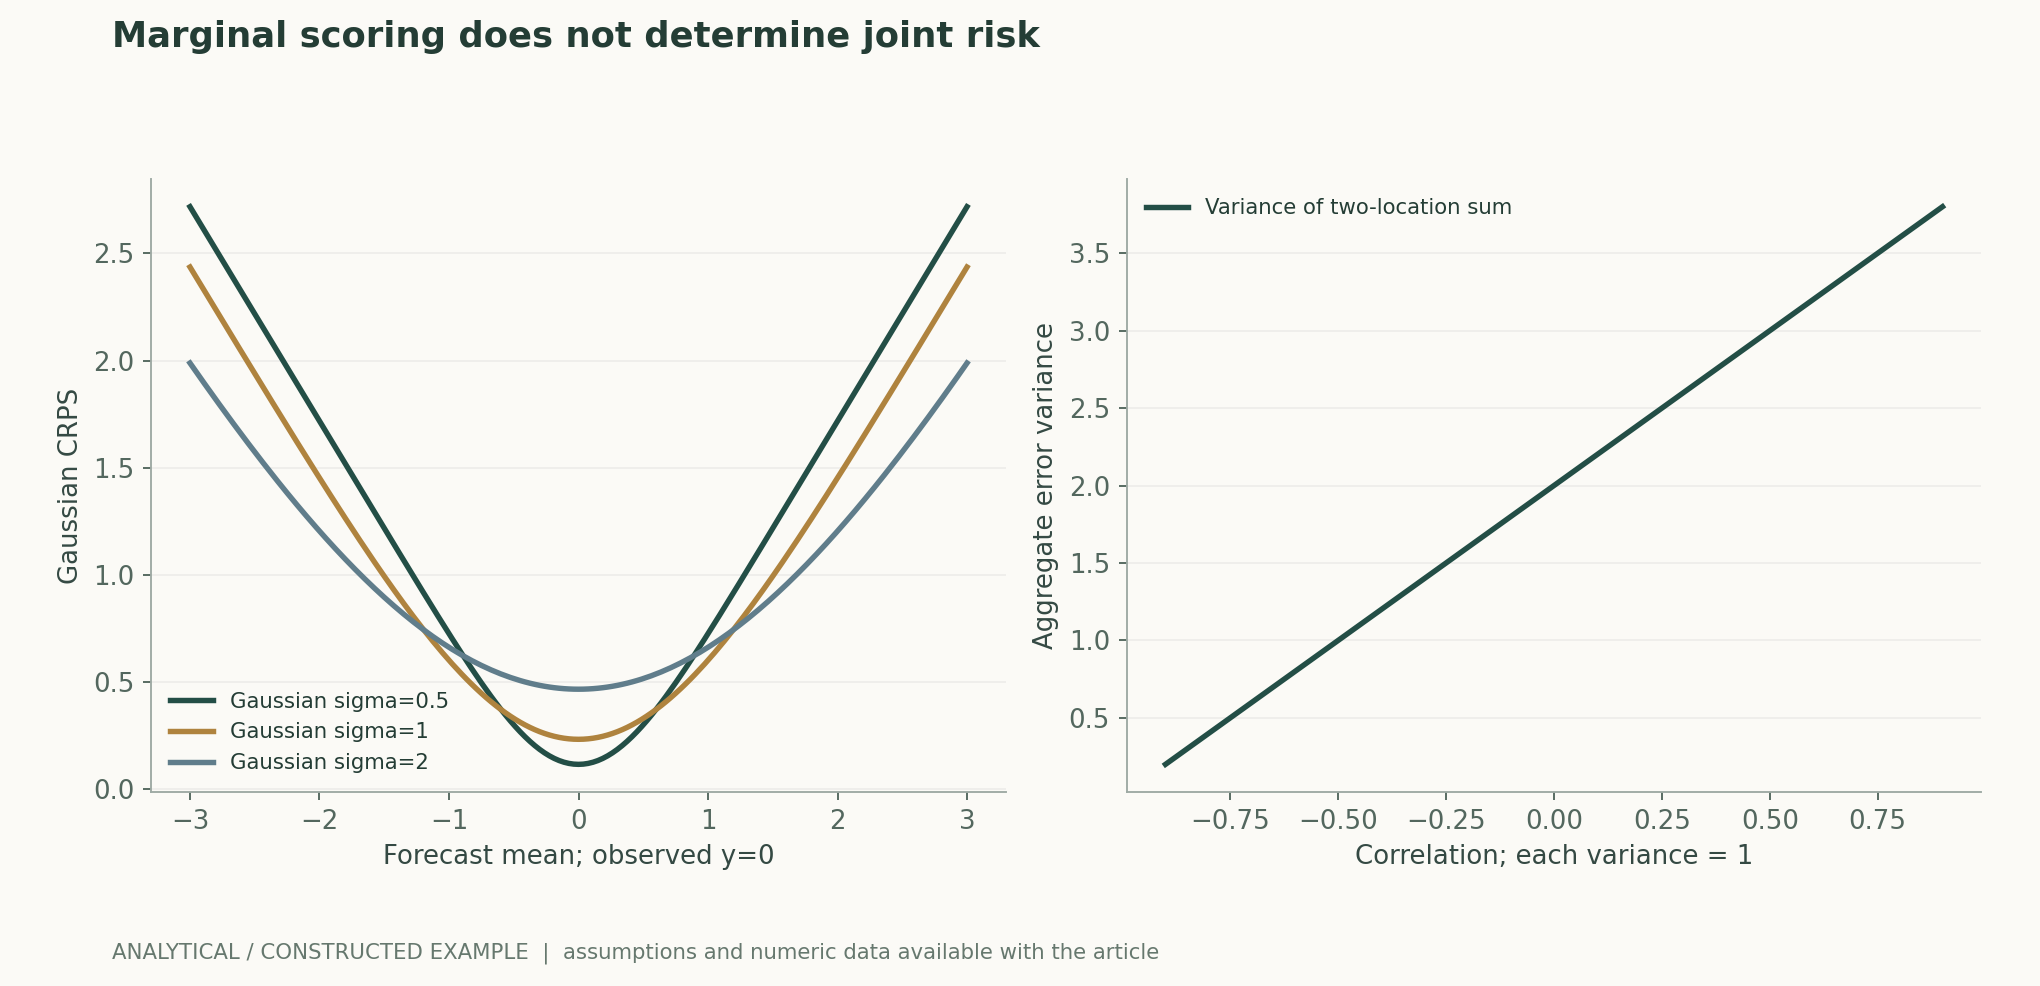
集合 CRPS 可写成成员到观测的平均绝对距离,减去成员两两距离的一半。第一项惩罚偏离观测,第二项防止把所有概率无条件压成单点;两者结合后,在期望意义上鼓励正确分布。本文用高斯解析式展示均值偏差与过窄、过宽集合的不同代价,并注明有限成员估计与理想分布评分的区别。一个更分散的集合不一定更好,过窄也不一定更准;应在相同验证样本上做配对比较,防止将不同天气难度误认为方法差异。作者分析与复核建议 / Author analysis
4. 校准与锐度必须在一起解释
GenCast 与 WeatherBench 2 使用多种概率诊断,包括集合离散与误差的关系。校准要求概率与事件频率相容,锐度则描述预测分布有多集中;只有在校准充分的前提下,集中的分布才有用。一个总是给出气候平均分布的系统可能相当校准,却几乎不提供个例信息。本文建议按季节、区域、时效和事件强度绘制可靠性,同时报告样本数。总体校准良好不能排除某个海域、某类极端或特定时效的系统过度自信。[1] Probabilistic weather forecasting with machine learning[3] WeatherBench 2: A benchmark for the next generation of
5. 本文反例:局部正确不保证联合风险正确
设两处归一化风电误差各自均值为零、方差为一,但相关系数为 ρ。总误差方差为 2+2ρ:ρ=−0.5 时为 1,ρ=0.8 时为 3.6,虽然两处的局部分布完全相同。这个解析例子说明,仅检查逐网格边际分布,可能漏掉对电网、流域或风暴路径重要的依赖。本文没有模拟真实电网,而是展示联合评价的必要性。应将集合成员中的时空关系保留下来再计算聚合指标,不能先独立重排各位置成员而破坏相关结构。作者分析与复核建议 / Author analysis
6. 本文推导:有限成员看不到不代表概率为零
当一个事件真实概率为 p,M 个独立成员都未出现它的概率为 (1−p) 的 M 次方。p=1%、M=50 时,这个概率仍约为 60.5%;因此“集合中没有”不能直接解释为“不可能”。实际成员可能相关,尾部有效信息更少。图展示不同成员数下的漏见概率,另标出经验概率步长 1/M。研究应区分模型本身的尾部偏差和采样分辨率,比较时匹配成员数,不能通过一个系统采更多成员就宣称分布建模更准确。作者分析与复核建议 / Author analysis
7. 初始化公平性决定比较是否回答同一个问题
WeatherBench 2 强调数据驱动与物理预报在初始化、参考分析及重网格上的一致性。再分析可使用与业务时点不同的信息窗口,如果不说明可用观测,离线优势可能混入额外信息。本文建议分别记录起报时间、资料截止、推理耗时和产品交付时间;用户真正获得的预报时效应从产品可用时刻计算。重网格与参考分析应固定,并保留对降水、近地面风或复杂地形等测量不确定性较大的变量的单独说明。[3] WeatherBench 2: A benchmark for the next generation of [1] Probabilistic weather forecasting with machine learning
8. 极端事件需要独立终点与时间块
极端高温、风暴路径和区域聚合量各有不同统计结构。若先试许多阈值再只发布最显著的一项,会产生选择偏差。本文建议预注册阈值与区域,以连续天气过程为时间块做配对重采样,并另报事件检出、误报与校准。一个风暴跨几十个时刻和网格,并不等于几十次独立极端事件。对少见事件,区间可能很宽,应该如实保留;有时可检验的结论是“目前证据不足”,而不是把不显著差异包装成两者完全等价。作者分析与复核建议 / Author analysis
9. 从评分走向决策价值
同一概率预报对不同损失结构的用户价值不同。准备成本低但漏报损失高的任务,会采用较低行动阈值;另一些任务则更担心误报。本文提出同时报告标准概率评分与预注册的成本损失曲线,用同一组冻结预报计算。阈值和损失来自明确使用场景,而不是为了凸显模型优势选择。若模型只改善边际 CRPS,却在聚合风险或特定决策阈值上退化,应把这个限制作为主要结果的一部分。作者分析与复核建议 / Author analysis
技术补充 A · 条件扩散与自回归轨迹
GenCast 对下一天气状态的条件分布采样,再将所得状态用于后续步骤,因此轨迹不确定性包含每一步条件生成和历史反馈。一次采样不是一个固定参数的误差条,而是一条内部相关的时空路径。本文建议保留轨迹成员身份、随机种子与各时刻变量,检验多步后是否出现不合理高频能量或漂移。单步评分优秀不保证长轨迹合理;同样,集合均值变得平滑也不意味着每个成员都缺乏结构,应分别检查。[1] Probabilistic weather forecasting with machine learning
技术补充 B · 有限集合评分存在估计器选择
经验分布 CRPS 的两两距离项使用 M² 分母,其中包含对角零项。若目标是对潜在连续预测分布的总体评分作无偏修正,会采用不同有限样本归一化。两者在大集合时接近,小集合时差异可能影响比较。本文固定使用页面公式所写经验分布评分,并要求不同系统成员数匹配;若采用修正版本,应明确名称和公式。不能一边增加成员、一边更换估计器,再把评分变化全部解释为模型更好。作者分析与复核建议 / Author analysis
技术补充 C · 空间谱与极端概率是互补检查
视觉逼真或高频谱合理说明成员保留某些结构,但不证明极端阈值发生频率正确。反过来,边际极端频率校准也可能由空间上不相干的样本实现。本文提出把谱、路径连续性与事件可靠性联合检查,并使用完全相同的成员集合。对于流域或区域总量,先对每个成员计算聚合,再评价聚合分布;先把成员平均成一张图会丢失非线性事件信息,尤其是阈值超越和最大值。作者分析与复核建议 / Author analysis
技术补充 D · 成本损失阈值来自使用场景
在最简单二元行动问题中,准备成本为 C,未准备而事件发生损失为 L,若准备可避免该损失,行动阈值为预测概率大于 C/L。这个推导说明同一预报可能对不同用户产生不同价值;也提醒成本函数应来自真实任务,不能为模型量身定制。若准备不能完全消除损失或有资源容量限制,阈值关系会改变。研究应先写明决策假设,再计算曲线,保留所有预定成本范围,而不是只截取最有利区间。作者分析与复核建议 / Author analysis
10. 结论:概率天气是一个分布与决策共同定义的任务
生成式天气模型的意义不止在于快速生成更多地图,而是提供能够支撑风险判断的未来集合。本文从评分、依赖和尾部分辨率三个角度说明,平均误差、校准、真实感与联合风险不能相互替代。公开交付应保存完整成员、初始化条件、变量单位及评价代码,并让每一个来源结果回到原测试设置。这样的证据链能让后续改进回答更具体的问题:模型改善的是哪一种不确定性,又在哪些条件下真正帮助了决策。作者分析与复核建议 / Author analysis
核心公式与推导
(1) 经验分布的集合 CRPS;它与有限集合的无偏总体评分修正不是同一个估计量。
LaTeX
\operatorname{CRPS}_M=\frac1M\sum_i|x_i-y|-\frac1{2M^2}\sum_{i,j}|x_i-x_j|(2) 高斯预测分布的解析评分,σ>0;用作可复算的校准示例。
LaTeX
\operatorname{CRPS}(\mathcal N(\mu,\sigma^2),y)=\sigma\left[z(2\Phi(z)-1)+2\phi(z)-\frac1{\sqrt\pi}\right],\quad z=\frac{y-\mu}{\sigma}(3) 边际方差相同并不能确定聚合风险;联合依赖必须另测。
LaTeX
\operatorname{Var}(X_1+X_2)=\sigma_1^2+\sigma_2^2+2\rho\sigma_1\sigma_2(4) 独立成员假设下漏见稀有事件的概率,不代表真实天气集合完全独立。
LaTeX
P(N_{\mathrm{event}}=0)=(1-p)^M方法与证据流程
解析图与数值示例
可复算例题
无偏单位高斯在y=0时CRPS=(sqrt(2)-1)/sqrt(pi)≈0.233695;rho=-0.5与0.8时总方差为1与3.6;50独立成员漏见1%事件概率约0.605006。
方法比较
| 能力 | 合适测量 | 常见错误解释 |
|---|---|---|
| 点估计 | 均值误差与偏差 | 代表所有可能轨迹 |
| 边际分布 | CRPS、可靠性与锐度 | 总体校准代替分层校准 |
| 成员结构 | 谱、路径与时序连续性 | 视觉锐利就是真实分布 |
| 联合风险 | 同成员聚合与事件依赖 | 逐网格正确即联合正确 |
| 极端尾部 | 固定阈值、事件数与区间 | 零成员出现即零概率 |
| 实际使用 | 资料截止、延迟与成本损失 | 推理速度等于全流程时效 |
复核与实验方案
- 固定起报、资料截止、参考分析和重网格规则。
- 匹配成员数、时效和变量集合,不合并不相容口径。
- 预注册 CRPS、分层校准、谱和联合风险等终点。
- 完整保留集合成员编号及时间关系,避免独立打乱位置。
- 按天气过程作时间块配对比较,以事件而非网格计独立样本。
- 固定极端阈值与行动成本,报告所有预定比较。
- 另测成员数与相关性对稀有事件估计的敏感性。
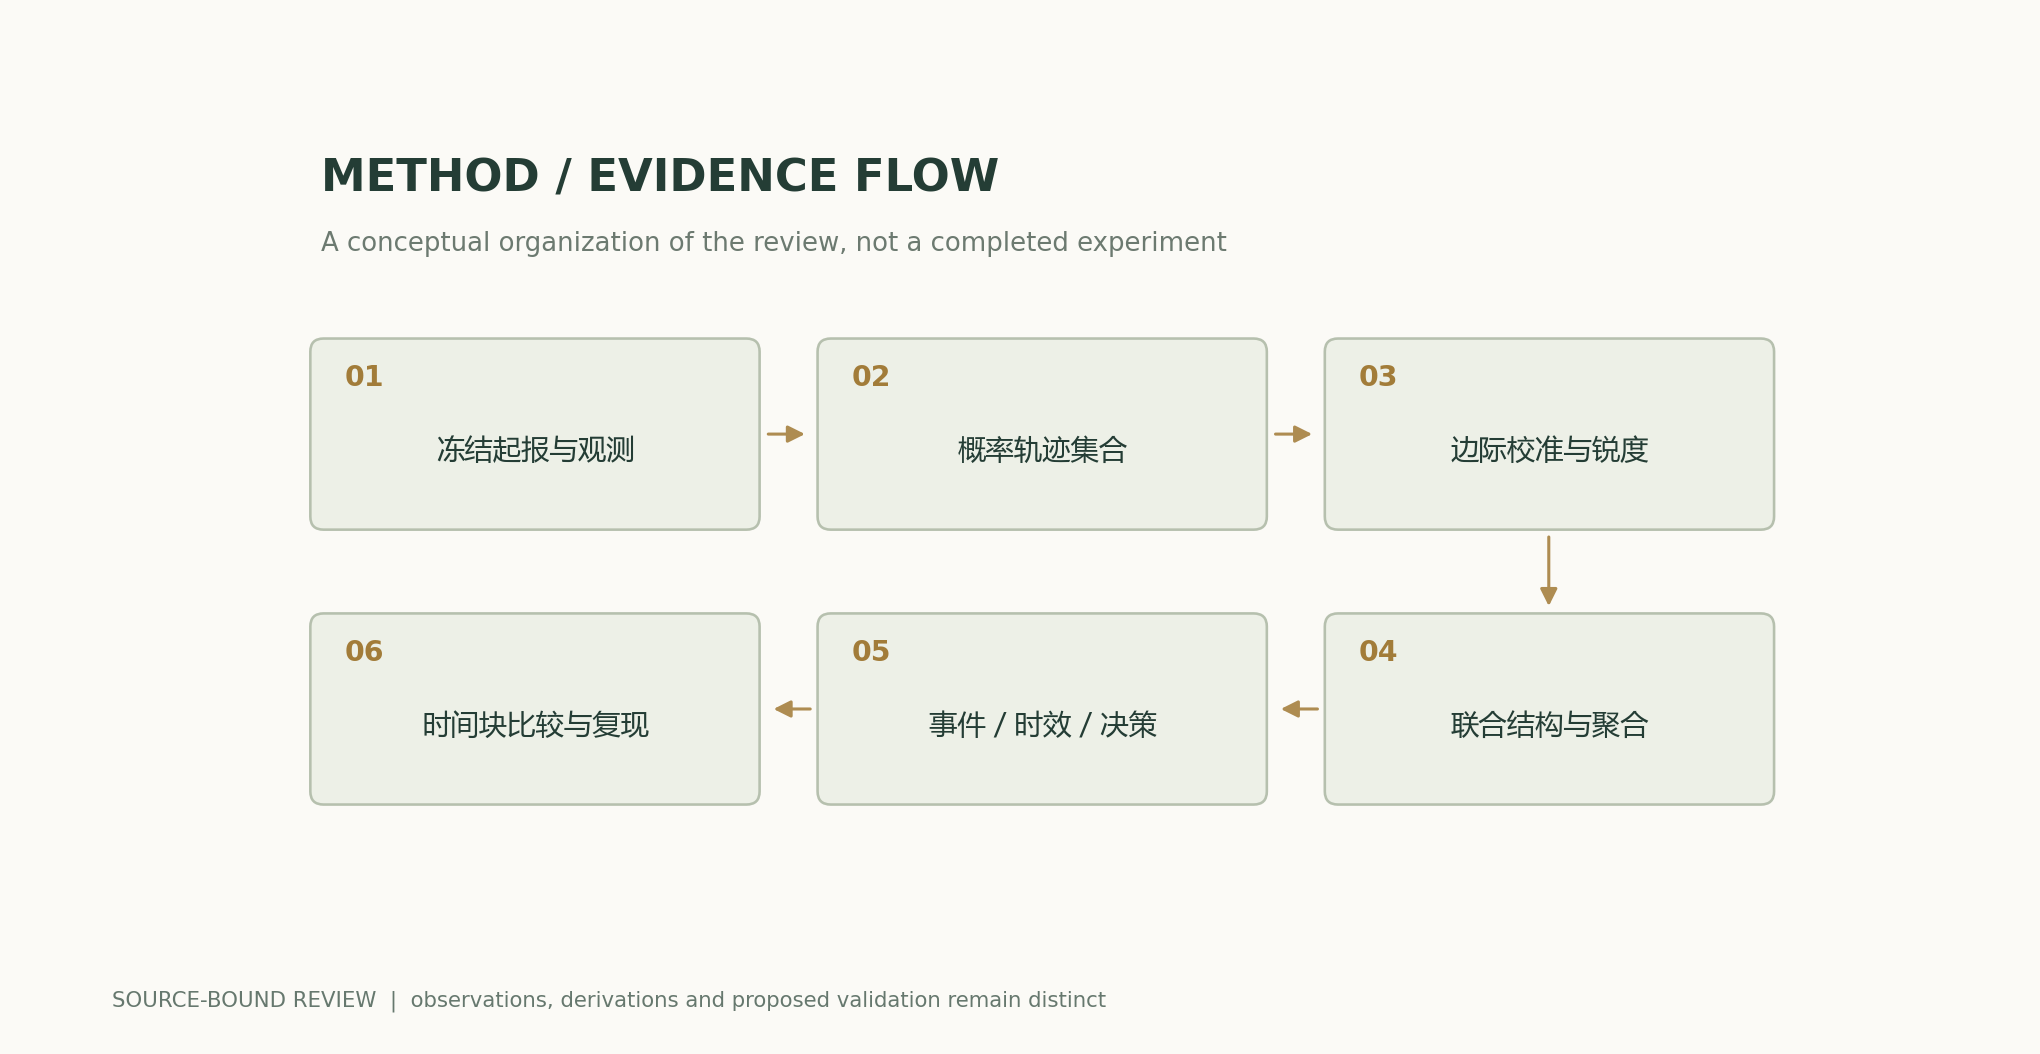
- 公开冻结预报和评价代码,区分原研究结果、本文解析与未执行的业务预报。
适用范围与局限
- 高斯、两位置相关与独立成员都是解析假设。
- 本文没有运行 GenCast 或产生真实天气预报。
- 原文 scorecard 目标相关,不能按独立二项任务解释。
- 单年回测不代表所有未来气候与极端。
- 再分析与业务产品可用信息存在差异,需要现场核验。
原研究证据与适用范围
| 原研究结果 | 适用范围 | 来源与位置 |
|---|---|---|
| 原文在 2019 比较中报告 1320 项 scorecard 中 97.2% 更优。 | 变量、时效与层次组合存在依赖;不是未来正确率。 | Probabilistic weather forecasting with machine learningAbstract; Baselines; Ensemble skill |
| 高效的确定性中期全球预报。 | 点预测能力不自动给出校准概率分布。 | GraphCast: Learning skillful medium-range global weather forecastingPrimary preprint abstract |
| 提供统一数据和多指标比较框架。 | 初始化和真值口径仍需逐模型核对。 | WeatherBench 2: A benchmark for the next generation of data-driven global weather modelsEvaluation design |
值得检验的研究问题
- 边际评分改善是否转化为同成员聚合风险的改善?
- 在相同成员预算下,哪些极端事件仍受采样分辨率限制?
- 以实际交付时间计算时效后,离线优势能保留多少?
一手来源与主张对应
- Probabilistic weather forecasting with machine learningPrice et al. · 2024-12-04Abstract; 2019 test period, 50-member comparison, CRPS scorecard and dependent verification targets.
- GraphCast: Learning skillful medium-range global weather forecastingLam et al. · 2022-12-24Authors' primary preprint; deterministic medium-range forecasts and verification scope; linked Science version.
- WeatherBench 2: A benchmark for the next generation of data-driven global weather modelsRasp et al. · 2023-08-29Primary benchmark specification: initialization, regridding, reference analyses and multiple diagnostic metrics.
引用与文稿导出
BibTeXRISCSL JSONTXTArticle JSON
作者、版本与来源
Codex(AI)撰写的有来源研究综述与原创解析。原论文实验归原研究团队;本文计算仅检验所列公式和明示假设。 本站尚无本篇独立同行评审或原创模型、临床及物理实验记录。
首次发布:AI与科学发现深度专题;保留逐节来源、原研究证据与作者解析的边界。
概念封面由 ImageGen 生成。科学图由随文代码与数值文件绘制,图注逐项说明假设与测量口径。
封面与科学图来源 · 数据、来源与假设 · Python · 可复算代码 · 发布与版本记录
Source revision: b7b48f7205d705b2a3d3e8de0be5e1b458e4869c